De fleste råd om skalering av WordPress hopper rett til lastbalansereren. Det er ofte feil grep.
En lastbalanserer løser en bestemt type problemer. Den hjelper når én applikasjonsserver ikke kan ta imot trafikken på en pålitelig måte, når du trenger redundans, eller når én enkelt maskin har blitt en driftsrisiko. Men på mange nettsteder gir en lastbalanserer som legges til for tidlig, flere bevegelige deler, flere feilmåter og mer forsinkelse enn verdi.
Det bedre spørsmålet er ikke «Hvordan legger vi til lastbalansering i WordPress?», men «Hvilken flaskehals prøver vi å fjerne?». På mindre installasjoner løser sterk sidehurtigbuffer, objekthurtigbuffer, databaseopprydding, avlastning av bilder og streng disiplin med utvidelser vanligvis problemet raskere og med mindre kompleksitet. I WordPress for større virksomheter kommer man likevel til et punkt der horisontal fordeling blir obligatorisk. Det er da arkitekturen begynner å bety mer enn finjustering.
Når du virkelig trenger lastbalansering for WordPress
Den vanlige antakelsen er enkel: flere servere betyr bedre ytelse. I praksis fungerer det ikke slik.
På WordPress-nettsteder med mindre trafikk kan lastbalansering gjøre ytelsen dårligere. SpinupWP påpeker at oppsett med én server yter bedre enn lastbalanserte oppsett opp til rundt 8 samtidige brukere, og at det ekstra nettverkshoppet kan gjøre forespørsler tregere når CPU-bruken er under 20 % (SpinupWPs analyse av lastbalanserere). Det er nyansen de fleste generelle guider hopper over.
Når en lastbalanserer er for tidlig
Hvis nettstedet ditt i hovedsak består av innhold som kan hurtigbufres, bør du begynne et annet sted. Én godt finjustert server med fullside-hurtigbuffer, Redis som objekthurtigbuffer, et CDN og disiplinert bruk av utvidelser slår ofte en distribuert stakk som ikke er designet med tanke på tilstand, lagring og konsistent hurtigbuffer.
Du trenger sannsynligvis ikke lastbalansering for WordPress ennå hvis dagens problemer ser slik ut:
- Bufferbom på grunn av utvidelser som oppfører seg dårlig: Én utvidelse omgår sidehurtigbufferen og får hele stakken til å føles treg.
- Oppblåste medier og treg levering av ressurser: Store opplastinger og uoptimaliserte bilder belaster I/O eller båndbredde til det ytterste.
- Databasedrift: Autoloadede innstillinger, utløpte transienter og unødvendige spørringer legger unødvendig arbeid til hver forespørsel.
- Enkel drift betyr mer: Teamet ditt trenger pålitelighet og rask tilbakerulling, ikke en større flate å vedlikeholde.
For team som skal avgjøre om de først bør investere i skaleringsarkitektur eller i grunnleggende ytelsesarbeid, er dette vanligvis punktet der en gjennomgang fra en erfaren ekspert lønner seg. WordPress-løsninger for virksomheter fungerer best når de tar utgangspunkt i den faktiske flaskehalsen, ikke i det mest populære mønsteret.
Tommelfingerregel: Hvis hurtigbuffer og databasehygiene ikke er gjort skikkelig, skjuler en ny lastbalanserer vanligvis problemet i stedet for å løse det.
Når det blir nødvendig
Lastbalansering begynner å gi mening når tilgjengelighet og samtidighet betyr mer enn enkel arkitektur. Tenk på produktlanseringer, store WooCommerce-kampanjer, medlemsplattformer med mye trafikk fra innloggede brukere, mediesider med trafikktopper eller virksomhetsnettsteder som ikke har råd til at én node svikter.
I slike tilfeller handler kravet ikke bare om hastighet. Det handler om robusthet. Du trenger at én node kan svikte uten å ta med seg hele plattformen. Du trenger helsesjekker, forutsigbar ruting og infrastruktur som tåler topper uten å tvinge frem nødendringer under press.
Det er da lastbalansering for WordPress slutter å være valgfritt og blir infrastruktur.
Slik fungerer arkitekturen for lastbalansering
Et produksjonsklart, lastbalansert WordPress-oppsett har fire bevegelige deler: en lastbalanserer foran, flere tilstandsløse applikasjonsnoder bak den, delt tilgang til opplastinger og et sentralt hurtigbufferlag som alle nodene kan bruke.
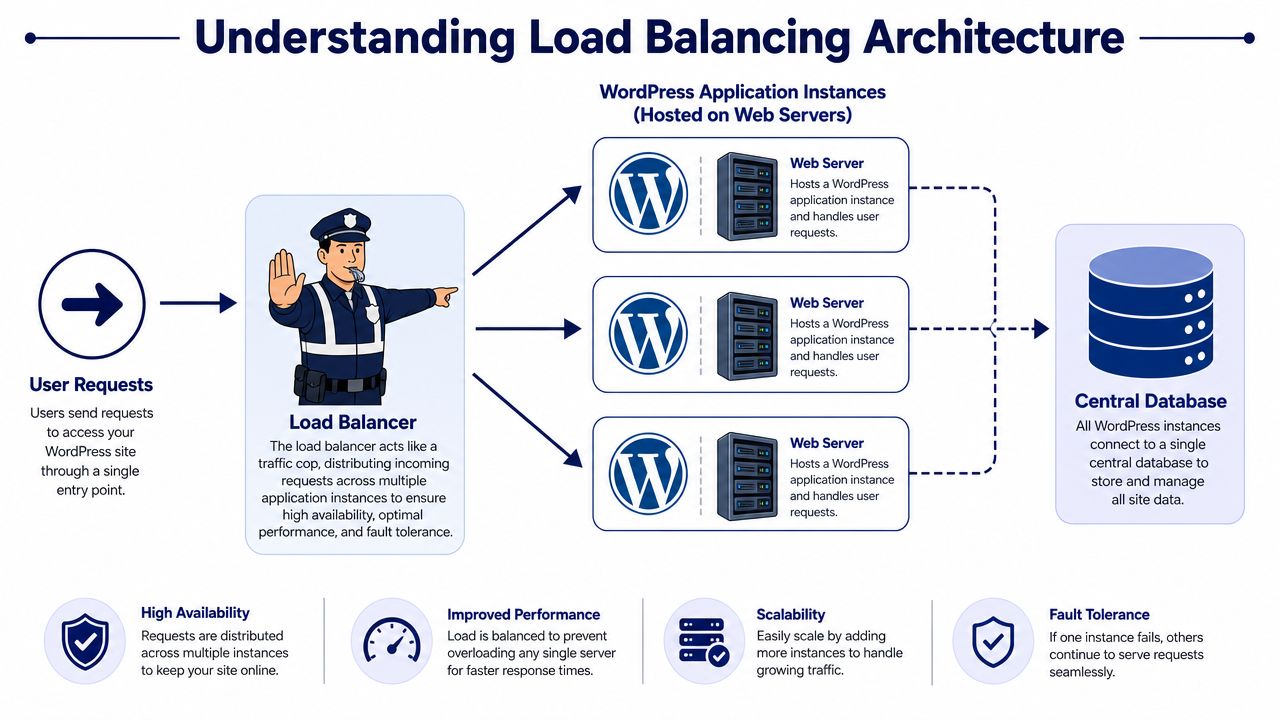
Det høres enkelt ut, men det er også her mindre WordPress-installasjoner blir tregere, mer skjøre og dyrere. Arkitekturen hjelper bare hvis hvert lag løser en reell flaskehals. Hvis trafikken fortsatt i hovedsak kan hurtigbufres og én finjustert node klarer den, gir distribuert infrastruktur flere nettverkshopp, flere feilpunkter og mer driftsarbeid uten særlig gevinst.
De fire delene som betyr noe
Hver komponent har en bestemt oppgave:
- Lastbalansereren eller den omvendte proxyen tar imot innkommende trafikk, sjekker helsen til backendene og sender forespørsler til en node som kan betjene dem.
- WordPress-applikasjonsnodene kjører PHP, behandler forespørsler som ikke ligger i hurtigbufferen, og bør behandles som utskiftbare arbeidere, ikke som langlivede «kjæledyr».
- Delt lagring eller avlastning av medier gjør opplastinger tilgjengelige for alle nodene, slik at filene ikke er avhengige av den lokale disken.
- En sentral objekthurtigbuffer gir alle nodene samme bilde av hurtigbufrede objekter og transienter, i stedet for at hver server bygger sin egen isolerte hurtigbuffer.
Det siste punktet blir ofte oversett. Team legger til en andre eller tredje webnode, men lar hurtigbuffer og filhåndtering forbli lokale. Resultatet er inkonsekvent oppførsel som bare viser seg under last. Én besøkende får en fersk oppføring i objekthurtigbufferen. En annen havner på en annen node og finner den ikke. En redaktør laster opp en fil, og én server ser den før de andre. WordPress kan fungere i en slik tilstand, men det fungerer ikke forutsigbart.
Hva hvert lag faktisk gjør
Den omvendte proxyen gjør mer enn å fordele trafikk med round-robin. I et seriøst oppsett håndterer den helsesjekker, bevarer riktige videresendingshoder, terminerer TLS hvis det passer designet, og tar ut noder med problemer før brukerne merker det. Nginx, HAProxy og administrerte lastbalanserere i skyen kan alle gjøre dette. Riktig valg avhenger mindre av funksjonslister og mer av hvem som skal vedlikeholde det klokken to om natten.
Applikasjonsnodene krever disiplin. De bør ikke lagre noe forretningskritisk på lokal disk eller være avhengige av vedvarende tilstand på noden, med mindre du bevisst har valgt det kompromisset. Hvis det krever manuell filsynkronisering eller spesiell opprydding å erstatte en node som har feilet, jobber arkitekturen allerede mot deg.
Lagring er der forhastede implementeringer vanligvis bryter sammen. WordPress forventer et konsistent bilde av wp-content/uploads, og noen utvidelser forutsetter fortsatt tilgang til det lokale filsystemet. Du kan løse dette med delt nettverkslagring eller ved å flytte medier til objektlagring og tilpasse stakken rundt det. Ingen av alternativene er gratis. Nettverksfilsystemer kan gi forsinkelse og låseproblemer. Avlastning av medier reduserer den risikoen, men du må teste kompatibiliteten med utvidelser og de redaksjonelle arbeidsflytene.
Det samme mønsteret dukker opp på større delte plattformer, særlig i WordPress Multisite-arkitekturer. Når flere nettsteder, redaktører og utvidelser er avhengige av den samme plattformen, blir inkonsekvent filtilstand og hurtigbuffer som spriker mellom nodene raskt til supporthenvendelser.
En sunn, lastbalansert WordPress-stakk handler mindre om å legge til servere og mer om å fjerne lokale antakelser. Det er arkitekturendringen som betyr noe.
Slik velger du arkitektur for lastbalansering
Det finnes ingen enkelt «beste» arkitektur for lastbalansering i WordPress. Det finnes flere gyldige mønstre, og hvert av dem vekter kontroll, kostnad og vedlikeholdsinnsats ulikt.
Feil valg kommer vanligvis av at man optimaliserer for én variabel. Team velger det billigste oppsettet og arver en tung driftsbyrde. Eller de velger det mest administrerte alternativet og oppdager senere at de ikke kan finjustere ruting eller observerbarhet slik de trenger. Riktig design avhenger av hvem som skal drifte det etter lansering, ikke bare av hvem som kan bygge det.
De tre vanlige mønstrene
De fleste WordPress-stakker for virksomheter havner i én av disse kategoriene:
| Arkitektur | Passer best for | Kompleksitet | Kostnad | Kontroll |
|---|---|---|---|---|
| Administrert lastbalanserer i skyen | Team som vil ha administrert infrastruktur og enklere skalering | Moderat | Moderat til høy | Moderat |
| Egendriftet proxy med Nginx eller HAProxy | Team med sterk DevOps-kompetanse og egne behov for ruting | Høy | Varierer | Høy |
| CDN-basert trafikkfordeling | Innholdstunge nettsteder som kan flytte mesteparten av trafikken ut til kanten | Lavere ved origin, men begrenset for full lastbalansering av applikasjonen | Varierer | Lavere over originens oppførsel |
Administrerte lastbalanserere i skyen
Administrerte lastbalanserere i skyen er vanligvis det tryggeste standardvalget for virksomhetsteam. De gir deg helsesjekker, TLS-håndtering, backend-grupper og integrasjon med automatisk skalering uten at teamet ditt må passe på enda en kritisk tjeneste.
De er særlig nyttige når infrastrukturen din allerede bygger på administrerte tjenester i database- og lagringslaget. Fordelen er lavere driftsbyrde. Ulempen er mindre detaljert finjustering, særlig hvis du trenger svært spesifikk rutingslogikk, tilpasset bufring eller uvanlig håndtering av hoder.
Egendriftede proxyer
Nginx og HAProxy gir deg dyp kontroll. Hvis du trenger egne upstream-regler, avansert failover eller et bestemt samspill mellom omskrivinger og hurtigbuffer, gir et egendriftet proxylag ingeniørene dine rom til å forme plattformen nøyaktig slik de vil.
Den kontrollen følger med ansvar:
- Du eier oppdateringene: Proxyen er enda en produksjonstjeneste som må oppdateres og sikres.
- Du eier observerbarheten: Logger, målinger, varsler og feilsøking av upstreams blir ditt problem.
- Du eier robustheten: Hvis proxylaget er underdesignet, blir det et enkelt feilpunkt.
For team som allerede drifter containerplattformer eller egen WordPress-hosting, kan dette være riktig vei. For team uten egen infrastrukturstøtte blir det ofte en kostbar avsporing.
CDN-baserte tilnærminger
Et CDN kan ta imot enorme mengder statisk trafikk og trafikk som kan hurtigbufres, noe som betyr at langt færre forespørsler når originen din. Det er verdifullt, men det er ikke det samme som full lastbalansering av applikasjonen.
Et CDN er sterkest når nettstedet ditt er innholdstungt, har et globalt publikum og kan hurtigbufres aggressivt. Det er svakere når forespørslene er dynamiske, personaliserte eller tett knyttet til innloggede økter. Hvis trafikken din i hovedsak kommer fra innloggede WooCommerce-kunder eller medlemmer, hjelper et CDN, men det erstatter ikke god arkitektur på origin.
Velg arkitekturen teamet ditt kan drifte en helt vanlig tirsdag, ikke bare i lanseringsuken.
Håndtering av økter og databasetilstand
Håndtering av tilstand er feilpunktet jeg oftest ser i prosjekter med lastbalansering for WordPress.
En WordPress-installasjon på én server kan klare seg med antakelser som slutter å fungere i det øyeblikket du legger til en andre applikasjonsnode. Forespørsler spretter mellom servere. Én node har en brukers øktdata i minnet, en annen har det ikke. Én node ser et nylig hurtigbufret objekt, en annen leverer utdaterte data. Hvis opplastinger, hurtigbufferoppføringer eller øktlignende data ligger på lokal disk eller i lokalt minne, slutter plattformen å oppføre seg som én applikasjon.
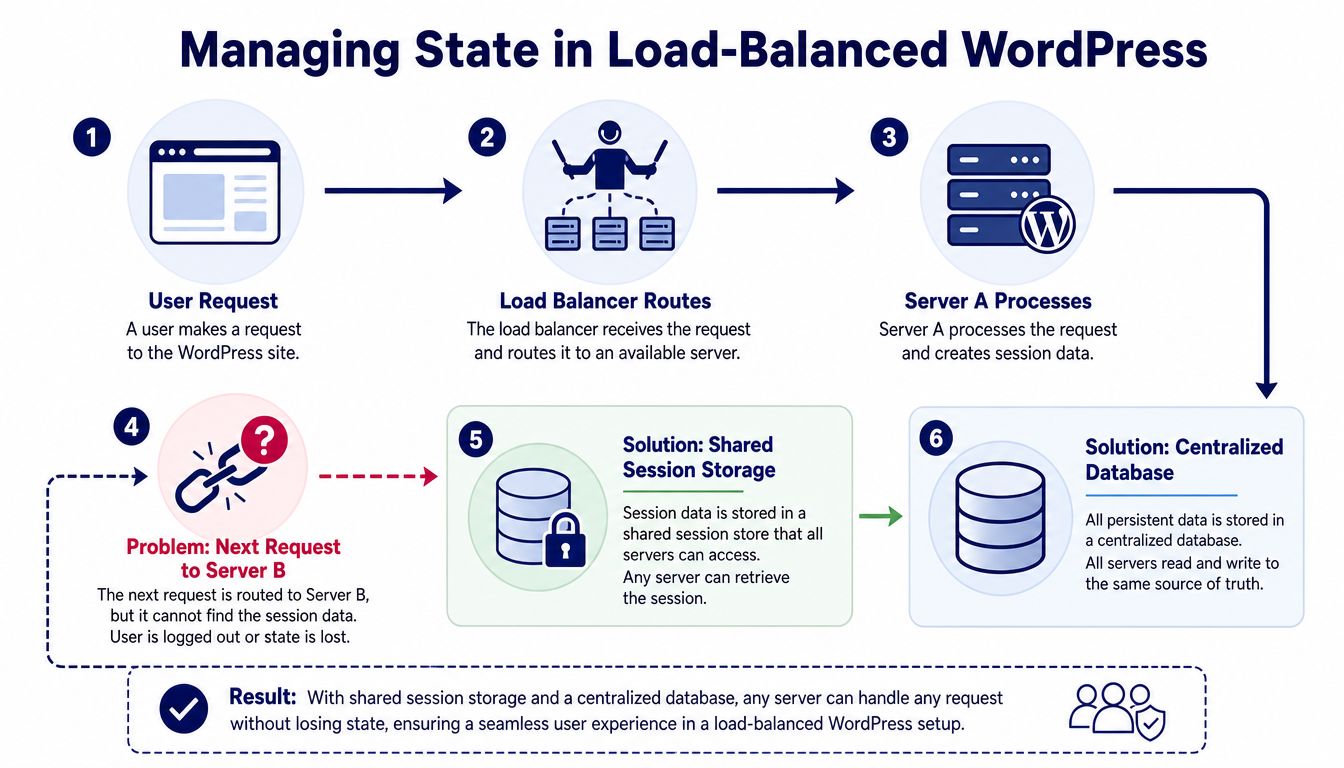
Derfor er lastbalansering ofte et dårlig første steg for mindre WordPress-nettsteder. Å legge til flere webnoder før du har fikset hurtigbufferstrategien, databaseeffektiviteten og fillagringen gir vanligvis mer forsinkelse og driftsrisiko uten å løse hovedflaskehalsen.
Hvorfor sticky sessions er et midlertidig kompromiss
Sticky sessions kan redusere feil som brukerne merker, ved å sende den samme besøkende til den samme backend-noden. Det kan hjelpe med trafikk fra innloggede brukere, handlekurver, medlemsflyter og eldre utvidelser som forutsetter lokal økttilstand.
Det er likevel et kompromiss, ikke et rent design.
Ulempene er forutsigbare:
- Failover blir svakere: Hvis den tildelte noden svikter, kan brukeren miste handlekurvens tilstand, øktens kontinuitet eller pågående handlinger.
- Trafikkfordelingen blir ujevn: Aktive brukere blir låst til bestemte noder, noe som skaper varme punkter.
- Feilsøkingen blir vanskeligere: Sporadiske problemer blir nodespesifikke og vanskeligere å gjenskape.
- Skaleringen blir mindre effektiv: Flere servere hjelper lite hvis en stor del av trafikken fortsatt sitter fast på noen få noder.
Jeg bruker bare sticky sessions når applikasjonen ikke kan gjøres tilstandsløs på kort sikt. Det er nyttig under en migrering. Det er ikke sluttilstanden.
Slik ser en renere arkitektur ut
For WordPress som trenger reell horisontal skalering, er det bedre mønsteret enkelt. Hold webnodene tilstandsløse. Legg vedvarende data i delte systemer som er laget for det.
I praksis betyr det vanligvis:
- Én primærdatabase for skriving, slik at innlegg, bestillinger, innstillingsendringer og administrative handlinger har én sannhetskilde.
- Lesereplikaer der de hjelper, for lesetunge arbeidslaster som tåler replikeringsforsinkelse.
- En delt objekthurtigbuffer som Redis, slik at transient- og objekthurtigbufferdata er tilgjengelige på alle applikasjonsnodene.
- Delt medielagring, slik at opplastinger ikke er knyttet til én server.
WP Farm sier det samme fra et hostingperspektiv. Delt hurtigbuffer og en tydelig databasetopologi reduserer fristelsen til å behandle wp-content som et tilstandslag, noe som vanligvis gir mer I/O-press og flere feilmåter enn teamene forventer (WP Farm om lastbalansering i WordPress-hosting).
Lesereplikaer fortjener en advarsel. De hjelper på innholdstunge nettsteder med mye lesing, men de kan skade arbeidslaster for netthandel og medlemskap hvis forsinkelsen i replikaen gir utdaterte lesinger etter skriving. En kunde oppdaterer adressen sin eller legger inn en bestilling, og den neste forespørselen leser fra en replika som ligger etter og viser gamle data. Det er ikke et teoretisk grensetilfelle. Det er en vanlig kilde til merkelige WooCommerce-feil.
For nettbutikker bør databasearbeidet gjøres før eller parallelt med utrullingen av lastbalanseringen. Optimalisering av WooCommerce-databasen gir vanligvis mer målbare forbedringer enn å legge flere PHP-noder oppå et ineffektivt spørringsmønster.
En praktisk test hjelper her. Hvis det å slå av én applikasjonsserver ville ødelagt innlogginger, handlekurver, opplastinger eller administrative arbeidsflyter, er plattformen ennå ikke klar for reell lastbalansering.
En rask illustrasjon gjør flyten tydeligere:
Hvis én webnode fortsatt bærer sin egen økt- eller applikasjonstilstand, har du flere servere, men ikke en ordentlig distribuert WordPress-applikasjon.
Praktisk implementering og konfigurasjon
Lastbalansering reparerer ikke en svak WordPress-installasjon. Den legger til enda et kontrollplan, enda et feilpunkt og mer driftsarbeid. På mindre nettsteder kan dette ekstra laget øke forsinkelsen og gjøre feilsøking vanskeligere uten å løse hovedflaskehalsen. Når du implementerer det, bør stakken allerede være så tilstandsløs at det å legge til eller fjerne en node endrer kapasiteten, ikke oppførselen.
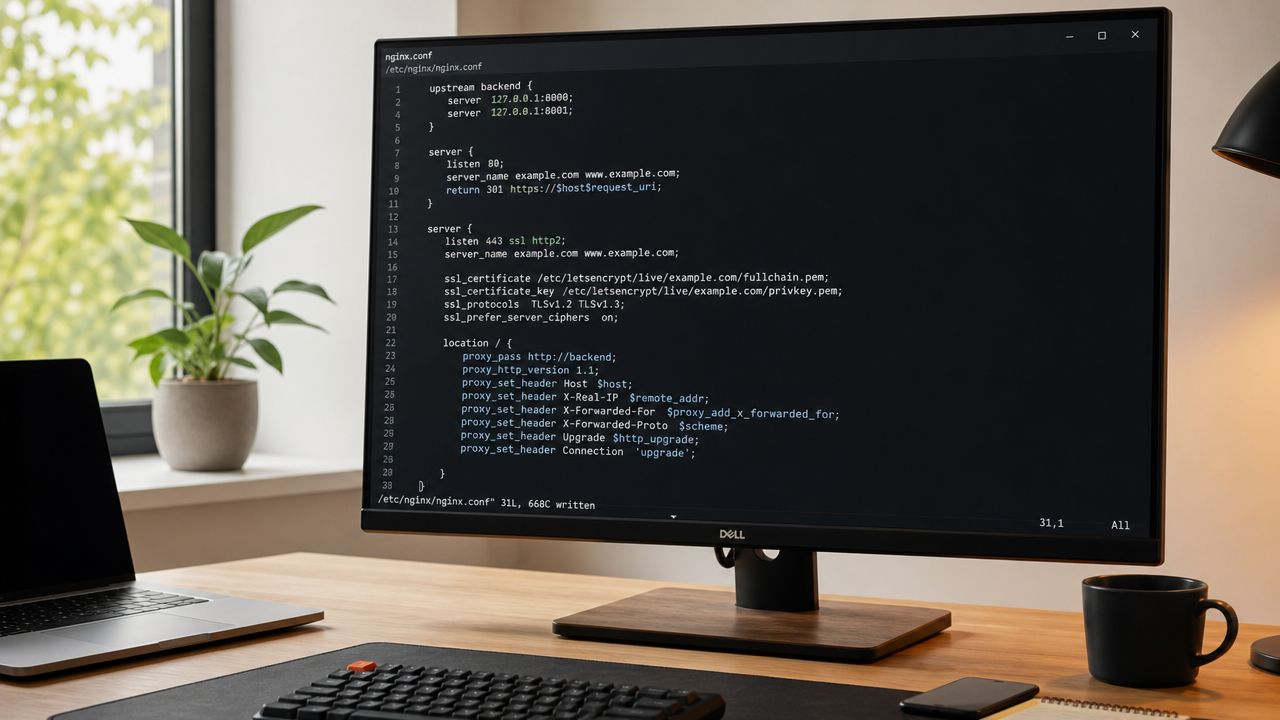
Et enkelt eksempel på omvendt proxy med Nginx
En omvendt proxy må gjøre noen få ting godt: holde det offentlige vertsnavnet stabilt, sende detaljene i den opprinnelige forespørselen videre til upstream og feile kontrollert når en node blir usunn. Syntaksen nedenfor er bevisst enkel, men den gjenspeiler grunnmønsteret mange team bruker før de legger til TLS-terminering, aktive helsesjekker og strengere regler for tidsavbrudd.
upstream wordpress_backend {
    server wordpress-app-1;
    server wordpress-app-2;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://wordpress_backend;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Det viktige er ikke selve kodesnutten. Proxyen må bevare nok kontekst til at WordPress, PHP, logger, sikkerhetsverktøy og upstream-hurtigbuffere kan ta riktige beslutninger. Hvis Host eller X-Forwarded-Proto er feil, begynner WordPress å generere feil URL-er, omdirigeringer går i løkke, og problemer med blandet innhold dukker raskt opp etter overgangen.
WordPress-innstillinger team ofte overser
Et WordPress-oppsett med flere noder svikter vanligvis på de kjedelige stedene.
Sett nettstedets URL og hjemme-URL til det offentlige domenet bak lastbalansereren, ikke til en enkelt applikasjonsserver eller en rå IP-adresse. I praksis definerer mange team også disse verdiene i wp-config.php, slik at de ikke kan endre seg i databasen under en forhastet migrering. Det er særlig nyttig når flere miljøer deler den samme utrullingsprosessen.
Opplastinger bør ikke bare ligge på lokal disk. Bruk objektlagring eller et delt filsystem du stoler på driftsmessig. Objektlagring er vanligvis det renere alternativet fordi det fjerner filsynkronisering og avvik mellom noder, men det gir også avhengigheter til utvidelser og endrer hvordan medie-URL-er, hurtigbufferhoder og bildebehandling oppfører seg. Delte filsystemer kan fungere, men under skrivetunge arbeidslaster blir de ofte den tregeste og minst forutsigbare delen av stakken.
Cron krever den samme disiplinen. Sett define('DISABLE_WP_CRON', true); og kjør planlagte oppgaver fra én kontrollert planlegger. Hvis alle webnodene kan utløse cron basert på reell trafikk, blir dupliserte jobber og kappløpssituasjoner et vanlig produksjonsproblem i stedet for et grensetilfelle.
En kompakt driftsmodell ser slik ut:
| Område | Praktisk valg | Hvorfor det hjelper |
|---|---|---|
| Opplastinger | S3 eller tilsvarende objektlagring | Holder mediene konsistente på tvers av noder |
| Database | Administrert relasjonsdatabasetjeneste | Reduserer administrasjonsbyrden og forbedrer gjenopprettingsevnen |
| Hurtigbuffer | Delt Redis-tjeneste | Hindrer fragmentert objekttilstand |
| Cron | Ekstern systemplanlegger | Hindrer duplisert kjøring av jobber på flere noder |
Bygg det og ødelegg det før produksjon
Den første reelle testen er svikt, ikke sidehastighet. Ta én applikasjonsnode ut av rotasjonen. Stopp PHP-FPM på en annen. Tøm hurtigbufferen midt i en redaksjonell publiseringsflyt. Kjør en oppdatering av en utvidelse og bekreft at administrasjon, innlogginger, opplastinger og asynkrone jobber fortsatt oppfører seg likt. Hvis disse testene er vanskelige å kjøre, er arkitekturen fortsatt for skjør.
Et skikkelig WordPress-testmiljø (staging) for å teste endringer i lastbalanseringen gir team et sted å øve på trinnene i overgangen, tilbakerulling, tømming av hurtigbuffer og utskifting av noder uten å sette inntekter eller publiseringsflyter i fare.
Behandle utrulling som konfigurasjonsstyring, ikke som håndarbeid på servere. Bak de samme versjonene av Nginx, PHP, WordPress og utvidelser inn i hver node. Hvis én server trenger en manuell rettelse for å bli værende i rotasjonen, er klyngen allerede i ferd med å drive bort fra spesifikasjonen.
Optimalisering av ytelse, sikkerhet og kostnad
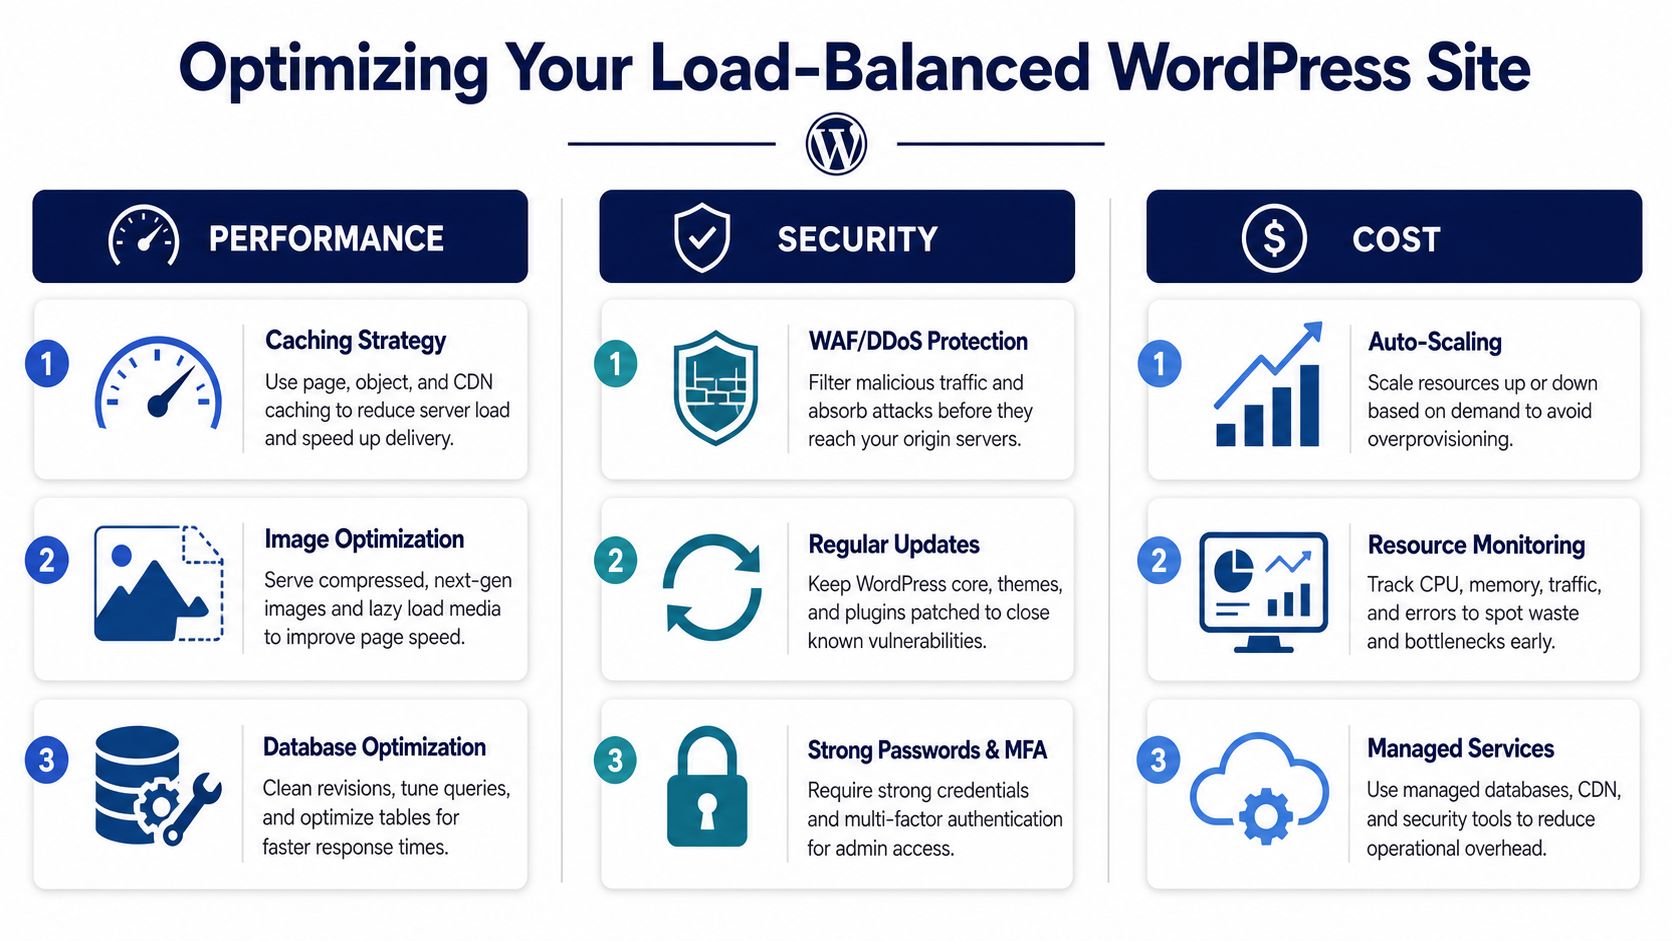
Lastbalansering gjør ikke en WordPress-stakk effektiv i seg selv. På mindre eller dårlig finjusterte nettsteder kan den legge til nettverkshopp, kompleksitet i hurtigbufferen og driftskostnader før den løser hovedflaskehalsen.
Ytelsesdisiplin
Når en klynge er i produksjon, avhenger ytelsen vanligvis mindre av selve lastbalansereren og mer av hvordan hurtigbufferen oppfører seg, hvor mye kapasitet PHP-arbeiderne har igjen, og mønstrene i databasespørringene. Derfor definerer modne team regler for hurtigbuffer eksplisitt i stedet for å behandle hurtigbufferen som en innstilling i en utvidelse.
En fornuftig standard er enkel. Hurtigbufre statiske ressurser aggressivt. Bruk kortere TTL for sider som endres ofte. Tøm hurtigbufferen ved innholdsoppdateringer, produktendringer og viktige redaksjonelle hendelser. De nøyaktige tidene avhenger av applikasjonen, men driftsprinsippet er det samme: stabilt innhold bør holdes unna PHP og MySQL så lenge som mulig.
Overvåking krever samme nivå av disiplin. Følg responstid, CPU-metning, utmattelse av PHP-arbeidere, treffrate i hurtigbufferen og databaseforsinkelse sammen. Oppetid alene skjuler mye smerte. Et nettsted kan fortsatt være teknisk tilgjengelig mens kassen blir tregere, administrative handlinger henger seg opp eller trafikk fra innloggede brukere begynner å stå i kø bak forespørsler som ikke er hurtigbufret.
Sett varslingsterskler tidlig nok til at teamet kan handle før brukerne merker noe. I mange WordPress-miljøer betyr det å varsle om vedvarende ressurspress og økende applikasjonsforsinkelse i stedet for å vente på et fullstendig driftsavbrudd.
Sikkerhetsnivå
Et lastbalansert WordPress-oppsett bør redusere angrepsflaten. Det offentlige inngangspunktet er lastbalansereren og sikkerhetslaget. Applikasjonsnodene bør ikke ta imot direkte trafikk fra internett, med mindre det finnes en konkret driftsmessig grunn og kompenserende kontroller.
Hold origin-instansene private der det er mulig. Begrens administrativ tilgang. Terminer TLS på en ryddig måte. Hvis nettstedet er særlig eksponert, plasser en WAF foran lastbalansereren og sørg for at tilgangsreglene for origin bare stoler på den veien. Dette betyr enda mer for WooCommerce, medlemsplattformer og redaksjoner som jobber i wp-admin fra mange steder.
Et sentralisert inngangspunkt gjør også hendelseshåndteringen ryddigere. Logger, begrensning av forespørsler, IP-kontroller og filtrering av roboter fungerer bedre når trafikken kommer inn gjennom én kontrollert vei.
Kostnadskontroll
Team overdimensjonerer ofte. En klynge med tre noder, administrert database, Redis, objektlagring, CDN, WAF og automatisk skalering kan være riktig svar for en forretningskritisk plattform. Det er også et dyrt svar på et problem som kanskje kunne vært løst med fullside-hurtigbuffer, bedre finjustering av spørringer eller mer kapasitet på én node.
Kostnadskontroll begynner med å tilpasse arkitekturen til arbeidslasten. Hvis trafikken kommer i topper, men i hovedsak er anonym, bør du først investere i hurtigbuffer og avlastning via CDN. Hvis trafikken er jevnt høy og kommer fra innloggede brukere, bør du rette mer oppmerksomhet mot PHP-samtidighet, effektiviteten i objekthurtigbufferen og databasekapasiteten. Hvis plattformen har strenge krav til tilgjengelighet, kan redundans forsvare høyere kostnader selv før gjennomsnittlig bruk ser høy ut.
En praktisk driftssjekkliste ser slik ut:
- Mål metning, ikke bare oppetid: Økende forsinkelse, fulle PHP-arbeiderpooler og lav treffrate i hurtigbufferen viser seg vanligvis før et driftsavbrudd.
- Bruk administrerte tjenester der de fjerner reelt slit: Administrerte database- og hurtigbufferlag er ofte verdt merkostnaden hvis teamet ikke vil eie sikkerhetskopiering, failover, oppdateringer og gjenoppretting.
- Vær ærlig om arkitekturen: Hvis delt lagring, kommunikasjon mellom noder eller bufferbom driver opp forsinkelsen, øker flere applikasjonsnoder vanligvis kostnadene raskere enn ytelsen.
- Gå jevnlig gjennom hvordan automatisk skalering oppfører seg: Dårlige terskler kan skalere for sent under trafikktopper eller for ofte fordi applikasjonen er ineffektiv.
De beste lastbalanserte WordPress-plattformene er ikke de største. Det er de der hvert ekstra lag har en tydelig oppgave, en målbar gevinst og en driftskostnad teamet forstår.
Din migreringsvei til en skalerbar arkitektur
Behandle migreringen som et ingeniørprosjekt i faser, ikke som et bytte av hosting.
Begynn med å måle ytelsen på dagens plattform, slik at du vet om det underliggende problemet er CPU, PHP-arbeidere, konkurranse om databasen, bufferbom eller fil-I/O. Bygg deretter målmiljøet i staging og valider de vanskelige delene først: innloggingsoppførsel, konsistente medier, administrative arbeidsflyter, planlagte oppgaver og ugyldiggjøring av hurtigbufferen.
Kjør deretter kontrollerte tester mot den nye stakken og øv på svikt. Ta en node ut av rotasjonen. Bekreft at nettstedet fortsatt fungerer som det skal. Test publisering av innhold og eventuelle kasse- eller medlemsflyter under realistiske forhold. Først da bør du planlegge overgangen.
De ryddigste migreringene bruker en trinnvis lansering med tett overvåking rett etter at trafikken er flyttet. Det gir teamet rom til å oppdage problemer med tilstand, hurtigbuffer eller ruting før de blir til forretningshendelser.
Lastbalansering for WordPress er verdt det når plattformen har vokst ut av én node. Det er en feil når det brukes som erstatning for grunnleggende ytelsesarbeid. Forskjellen ligger i disiplinen i arkitekturen.
Hvis teamet ditt planlegger overgangen til klyngebasert WordPress, WooCommerce med mye trafikk eller en mer robust virksomhetsstakk, kan IMADO hjelpe deg med å designe arkitekturen, validere migreringsveien og bygge en plattform som redaktørene og ingeniørene dine kan drifte.