La mayoría de los consejos sobre cómo escalar WordPress saltan directamente al balanceador de carga. A menudo es un error.
Un balanceador de carga resuelve un tipo concreto de problemas. Ayuda cuando un solo servidor de aplicaciones no puede absorber el tráfico de forma fiable, cuando usted necesita redundancia o cuando una única máquina se ha convertido en un riesgo operativo. Pero en muchos sitios, añadir un balanceador de carga demasiado pronto genera más piezas móviles, más modos de fallo y más latencia que valor.
La mejor pregunta no es «¿Cómo añadimos balanceo de carga a WordPress?», sino «¿Qué cuello de botella intentamos eliminar?». En proyectos más pequeños, una buena caché de páginas, la caché de objetos, la limpieza de la base de datos, la descarga de imágenes a otro almacenamiento y una disciplina cuidadosa con los plugins suelen resolver el problema más rápido y con menos complejidad. En WordPress empresarial, sin embargo, llega un punto en el que la distribución horizontal se vuelve obligatoria. Ahí es donde la arquitectura empieza a importar más que los ajustes puntuales.
Cuándo necesita realmente balanceo de carga en WordPress
La suposición más extendida es sencilla: más servidores significan mejor rendimiento. En la práctica, no funciona así.
En sitios WordPress con menos tráfico, el balanceo de carga puede empeorar el rendimiento. SpinupWP señala que las configuraciones de un solo servidor rinden más que las configuraciones con balanceo de carga hasta aproximadamente 8 usuarios concurrentes, y que el salto de red adicional puede ralentizar las peticiones cuando el uso de CPU está por debajo del 20 % (análisis de balanceadores de carga de SpinupWP). Ese es el matiz que omiten la mayoría de las guías genéricas.
Casos en los que un balanceador de carga es prematuro
Si su sitio es en su mayor parte contenido cacheable, empiece por otro lado. Un único servidor bien ajustado con caché de página completa, caché de objetos con Redis, una CDN y un uso disciplinado de plugins suele superar a una pila distribuida que no se ha diseñado pensando en el estado, el almacenamiento y la coherencia de la caché.
Probablemente no necesite todavía balanceo de carga en WordPress si sus problemas actuales son de este tipo:
- Fallos de caché por plugins que se comportan mal: Un plugin se salta la caché de páginas y hace que toda la pila parezca lenta.
- Medios sobredimensionados y entrega lenta de recursos: Las subidas grandes y las imágenes sin optimizar saturan la E/S o el ancho de banda.
- Deriva de la base de datos: Las opciones con carga automática, los transitorios caducados y las consultas innecesarias añaden trabajo evitable a cada petición.
- La simplicidad operativa importa más: Su equipo necesita fiabilidad y una reversión rápida, no una superficie más grande.
Para los equipos que deciden si invertir primero en arquitectura de escalado o en el trabajo básico de rendimiento, este suele ser el momento en el que compensa una revisión sénior. Las soluciones WordPress empresariales son más eficaces cuando parten del cuello de botella real, no del patrón de moda.
Regla práctica: Si la caché y la higiene de la base de datos no se han hecho correctamente, añadir un balanceador de carga suele ocultar el problema en lugar de resolverlo.
Casos en los que se vuelve necesario
El balanceo de carga empieza a tener sentido cuando la disponibilidad y la concurrencia importan más que la simplicidad de la arquitectura. Piense en lanzamientos de productos, grandes campañas de WooCommerce, plataformas de membresía con tráfico autenticado frecuente, sitios de editores con picos de tráfico o sitios empresariales que no pueden permitirse el fallo de un único nodo.
En esos casos, el requisito no es solo la velocidad. Es la resiliencia. Necesita que un nodo pueda fallar sin arrastrar consigo toda la plataforma. Necesita comprobaciones de estado, un enrutamiento predecible y una infraestructura que absorba los picos sin obligar a hacer cambios de emergencia bajo presión.
Es entonces cuando el balanceo de carga en WordPress deja de ser opcional y pasa a ser infraestructura.
Cómo funciona la arquitectura de balanceo de carga
Una configuración de WordPress con balanceo de carga lista para producción tiene cuatro piezas móviles: un balanceador de carga delante, varios nodos de aplicación sin estado detrás, acceso compartido a las subidas y una capa central de caché que todos los nodos pueden usar.
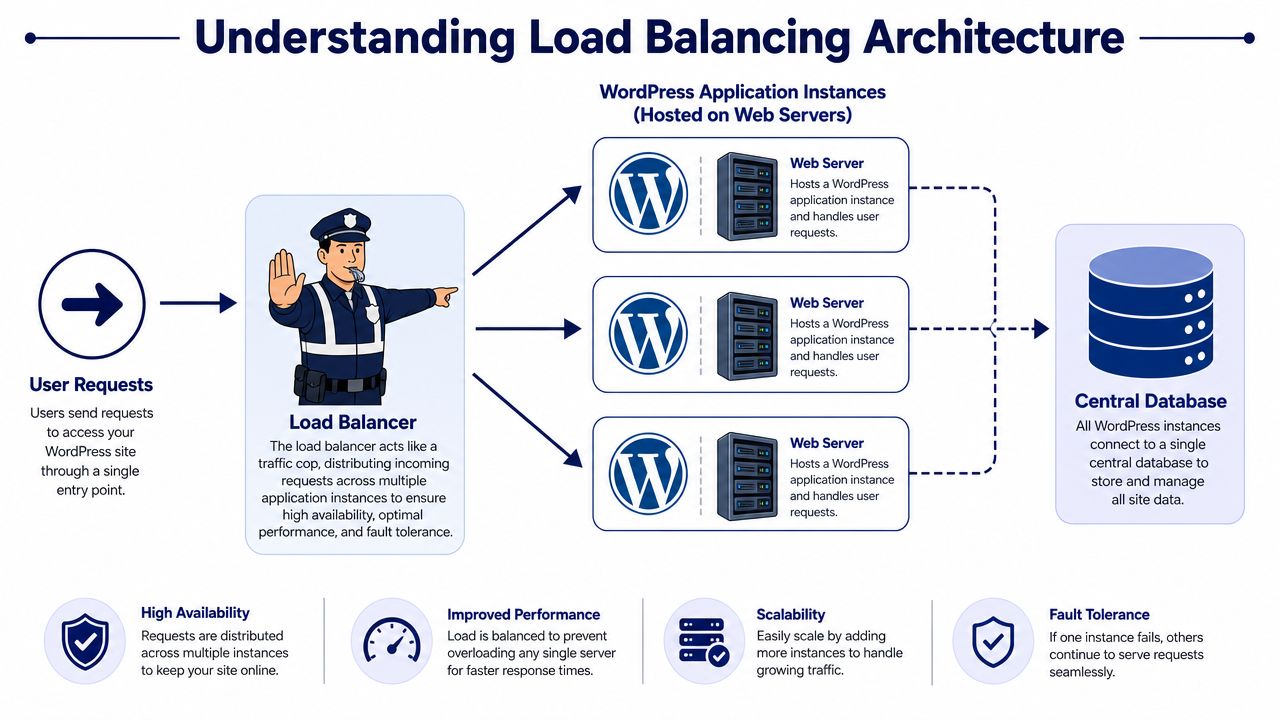
Parece sencillo, pero también es el punto en el que las instalaciones WordPress más pequeñas se vuelven más lentas, más frágiles y más caras. La arquitectura solo ayuda si cada capa resuelve un cuello de botella real. Si el tráfico sigue siendo mayoritariamente cacheable y un único nodo bien ajustado puede gestionarlo, añadir infraestructura distribuida genera saltos de red, más puntos de fallo y más trabajo operativo sin apenas beneficio.
Las cuatro piezas que importan
Cada componente tiene una función concreta:
- El balanceador de carga o proxy inverso acepta el tráfico entrante, comprueba el estado de los backends y envía las peticiones a un nodo que pueda atenderlas.
- Los nodos de aplicación de WordPress ejecutan PHP, procesan las peticiones que no están en caché y deben tratarse como trabajadores reemplazables, no como «mascotas» de larga vida.
- El almacenamiento compartido o la descarga de medios pone las subidas a disposición de todos los nodos para que los archivos no dependan del disco local.
- Una caché de objetos central da a todos los nodos la misma visión de los objetos y transitorios en caché, en lugar de dejar que cada servidor construya su propia caché aislada.
Ese último punto se pasa por alto con frecuencia. Los equipos añaden un segundo o tercer nodo web, pero dejan la caché y la gestión de archivos en local. El resultado es un comportamiento incoherente que solo aparece bajo carga. Un visitante obtiene una entrada nueva en la caché de objetos. Otro llega a un nodo distinto y no la encuentra. Un editor sube un archivo y un servidor lo ve antes que los demás. WordPress puede funcionar en ese estado, pero no funciona de forma predecible.
Lo que hace realmente cada capa
El proxy inverso hace más que repartir tráfico en round-robin. En una configuración seria, gestiona las comprobaciones de estado, conserva las cabeceras de reenvío correctas, termina TLS si encaja en su diseño y retira los nodos con problemas antes de que los usuarios lo noten. Nginx, HAProxy y los balanceadores gestionados en la nube pueden hacer todo esto. La elección correcta depende menos de las listas de funciones y más de quién lo mantendrá a las 2 de la madrugada.
Los nodos de aplicación necesitan disciplina. No deben guardar nada crítico para el negocio en el disco local ni depender de un estado persistente en el nodo, salvo que usted haya elegido ese compromiso de forma deliberada. Si sustituir un nodo caído exige sincronizar archivos a mano o hacer una limpieza especial, la arquitectura ya está jugando en su contra.
El almacenamiento es donde suelen fallar las implementaciones hechas con prisas. WordPress espera una visión coherente de wp-content/uploads, y algunos plugins todavía dan por hecho el acceso al sistema de archivos local. Puede resolverlo con almacenamiento compartido en red o descargando los medios a un almacenamiento de objetos y ajustando la pila en torno a ello. Ninguna opción es gratuita. Los sistemas de archivos en red pueden añadir latencia y problemas de bloqueo. La descarga de medios reduce ese riesgo, pero hay que probar la compatibilidad de los plugins y los flujos de trabajo editoriales.
El mismo patrón aparece en plataformas compartidas más grandes, sobre todo en las arquitecturas de WordPress Multisite. En cuanto varios sitios, editores y plugins dependen de la misma plataforma, un estado de archivos incoherente y una caché que diverge entre nodos se convierten rápidamente en incidencias de soporte.
Una pila WordPress sana con balanceo de carga no consiste tanto en añadir servidores como en eliminar suposiciones locales. Ese es el cambio de arquitectura que importa.
Cómo elegir su arquitectura de balanceo de carga
No existe una única arquitectura «mejor» para el balanceo de carga en WordPress. Hay varios patrones válidos, y cada uno equilibra de forma distinta el control, el coste y el esfuerzo de mantenimiento.
La elección equivocada suele venir de optimizar una sola variable. Los equipos eligen la configuración más barata y heredan una gran carga operativa. O eligen la opción más gestionada y después descubren que no pueden ajustar el enrutamiento ni la observabilidad como necesitan. El diseño adecuado depende de quién lo operará después del lanzamiento, no solo de quién sabe construirlo.
Los tres patrones habituales
La mayoría de las pilas WordPress empresariales encajan en una de estas categorías:
| Arquitectura | Ideal para | Complejidad | Coste | Control |
|---|---|---|---|---|
| Balanceador de carga gestionado en la nube | Equipos que quieren infraestructura gestionada y un escalado más sencillo | Moderada | De moderado a alto | Moderado |
| Proxy autoalojado con Nginx o HAProxy | Equipos con una gran capacidad DevOps y necesidades de enrutamiento personalizadas | Alta | Variable | Alto |
| Distribución del tráfico basada en CDN | Sitios con mucho contenido que pueden llevar la mayor parte del tráfico al edge | Menor en el origen, pero limitada para un balanceo completo de la aplicación | Variable | Menor sobre el comportamiento del origen |
Balanceadores de carga gestionados en la nube
Los balanceadores gestionados en la nube suelen ser la opción por defecto más segura para equipos empresariales. Ofrecen comprobaciones de estado, gestión de TLS, grupos de backends e integración con el autoescalado sin obligar a su equipo a vigilar otro servicio crítico.
Son especialmente útiles cuando su infraestructura ya depende de servicios gestionados para la capa de base de datos y almacenamiento. La ventaja es una menor carga operativa. El inconveniente es un ajuste menos granular, sobre todo si necesita una lógica de enrutamiento muy específica, un comportamiento de buffering personalizado o una gestión poco habitual de las cabeceras.
Proxies autoalojados
Nginx y HAProxy le dan un control profundo. Si necesita reglas upstream personalizadas, un comportamiento avanzado de conmutación por error o una interacción concreta entre reescrituras y caché, una capa de proxy autoalojada da a sus ingenieros margen para dar forma a la plataforma exactamente como quieren.
Ese control conlleva responsabilidad:
- Usted se encarga de los parches: El proxy es un servicio de producción más que hay que actualizar y proteger.
- Usted se encarga de la observabilidad: Los logs, las métricas, las alertas y la depuración de los upstreams pasan a ser su problema.
- Usted se encarga de la resiliencia: Si la capa de proxy está mal diseñada, se convierte en un punto único de fallo.
Para los equipos que ya operan plataformas de contenedores o hosting propio de WordPress, este puede ser el camino adecuado. Para los equipos sin soporte de infraestructura dedicado, a menudo se convierte en una distracción cara.
Enfoques basados en CDN
Una CDN puede absorber enormes cantidades de tráfico estático y cacheable, lo que significa que muchas menos peticiones llegan a su origen. Es valioso, pero no es lo mismo que un balanceo de carga completo de la aplicación.
Una CDN rinde mejor cuando su sitio tiene mucho contenido, una audiencia global y se puede cachear de forma agresiva. Rinde peor cuando las peticiones son dinámicas, personalizadas o están muy ligadas a sesiones autenticadas. Si su tráfico procede sobre todo de clientes de WooCommerce o miembros con sesión iniciada, una CDN ayuda, pero no sustituye a una buena arquitectura de origen.
Elija la arquitectura que su equipo pueda operar un martes cualquiera, no solo durante la semana de lanzamiento.
Gestión de sesiones y del estado de la base de datos
La gestión del estado es el punto de fallo que veo con más frecuencia en los proyectos de balanceo de carga en WordPress.
Una instalación de WordPress en un solo servidor puede permitirse suposiciones que dejan de funcionar en cuanto se añade un segundo nodo de aplicación. Las peticiones rebotan entre servidores. Un nodo tiene en memoria los datos de sesión de un usuario y otro no. Un nodo ve un objeto recién cacheado y otro sirve datos obsoletos. Si las subidas, las entradas de caché o los datos similares a sesiones viven en el disco local o en la memoria local, la plataforma deja de comportarse como una sola aplicación.
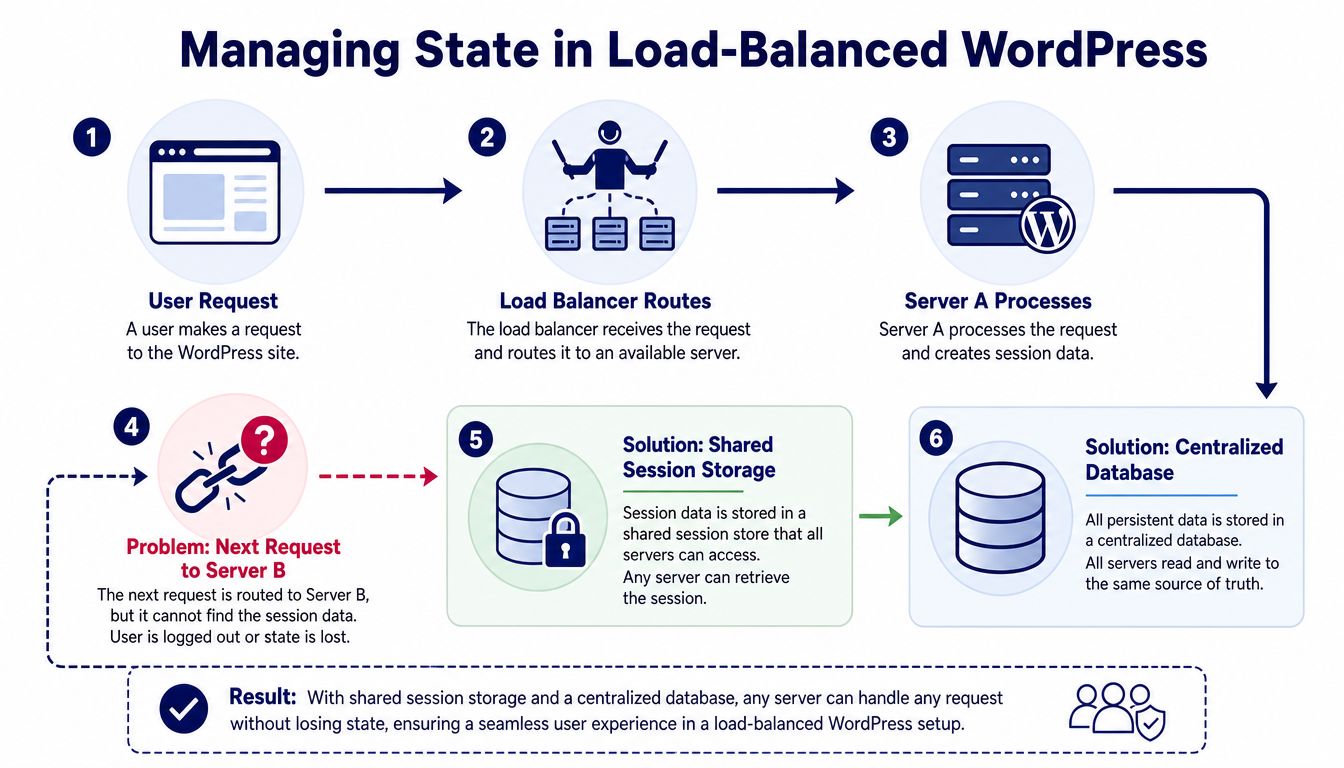
Por eso el balanceo de carga suele ser un mal primer paso para los sitios WordPress más pequeños. Añadir más nodos web antes de arreglar la estrategia de caché, la eficiencia de la base de datos y el almacenamiento de archivos suele añadir latencia y riesgo operativo sin resolver el principal cuello de botella.
Por qué las sesiones persistentes son un compromiso temporal
Las sesiones persistentes (sticky sessions) pueden reducir los fallos visibles para el usuario enviando al mismo visitante siempre al mismo nodo de backend. Eso puede ayudar con el tráfico autenticado, los carritos, los flujos de membresía y los plugins antiguos que dan por hecho un estado de sesión local.
Aun así, sigue siendo un compromiso, no un diseño limpio.
Las contrapartidas son previsibles:
- La conmutación por error se debilita: Si el nodo asignado falla, el usuario puede perder el estado del carrito, la continuidad de la sesión o las acciones en curso.
- La distribución del tráfico se vuelve desigual: Los usuarios más activos quedan anclados a nodos concretos, lo que crea puntos calientes.
- La resolución de problemas se complica: Los fallos intermitentes pasan a depender del nodo y son más difíciles de reproducir.
- El escalado pierde eficiencia: Añadir más servidores ayuda poco si una gran parte del tráfico sigue pegada a unos pocos nodos.
Solo uso sesiones persistentes cuando la aplicación no puede hacerse sin estado a corto plazo. Son útiles durante una migración. No son el estado final.
Cómo es una arquitectura más limpia
Para un WordPress que necesita un escalado horizontal real, el mejor patrón es sencillo. Mantenga los nodos web sin estado. Ponga los datos persistentes en sistemas compartidos diseñados para ello.
En la práctica, eso suele significar:
- Una base de datos principal para las escrituras, de modo que las entradas, los pedidos, los cambios de configuración y las acciones de administración tengan una única fuente de verdad.
- Réplicas de lectura donde ayuden, para cargas con muchas lecturas que toleren el retraso de replicación.
- Una caché de objetos compartida como Redis, para que los datos de transitorios y de la caché de objetos estén disponibles en todos los nodos de aplicación.
- Almacenamiento compartido de medios, para que las subidas no estén ligadas a un único servidor.
WP Farm plantea lo mismo desde la perspectiva del hosting. Una caché compartida y una topología de base de datos clara reducen la tentación de tratar wp-content como una capa de estado, algo que suele generar más presión de E/S y más modos de fallo de lo que los equipos esperan (WP Farm sobre el balanceo de carga en el hosting de WordPress).
Las réplicas de lectura merecen una advertencia. Ayudan en sitios con mucho contenido y un gran volumen de lecturas, pero pueden perjudicar a las cargas de comercio electrónico y membresía si el retraso de la réplica provoca lecturas obsoletas después de una escritura. Un cliente actualiza su dirección o hace un pedido, y la siguiente petición lee de una réplica retrasada y muestra datos antiguos. No es un caso límite teórico. Es una fuente habitual de errores extraños en WooCommerce.
En las tiendas, el trabajo en la base de datos debe hacerse antes del despliegue del balanceo de carga o en paralelo. La optimización de la base de datos de WooCommerce suele producir mejoras más medibles que añadir nodos PHP adicionales a un patrón de consultas ineficiente.
Aquí ayuda una prueba práctica. Si apagar un servidor de aplicaciones rompiera los inicios de sesión, los carritos, las subidas o los flujos de administración, la plataforma todavía no está preparada para un balanceo de carga real.
Una imagen rápida ayuda a aclarar el flujo:
Si un nodo web sigue guardando un estado de sesión o de aplicación propio, tiene varios servidores, pero no una aplicación WordPress correctamente distribuida.
Implementación y configuración en la práctica
El balanceo de carga no arregla una instalación de WordPress débil. Añade otro plano de control, otro punto de fallo y más trabajo operativo. En sitios más pequeños, esa capa adicional puede aumentar la latencia y complicar la resolución de problemas sin resolver el principal cuello de botella. Cuando lo implemente, la pila ya debería ser lo bastante sin estado como para que añadir o quitar un nodo cambie la capacidad, no el comportamiento.
Un ejemplo sencillo de proxy inverso con Nginx
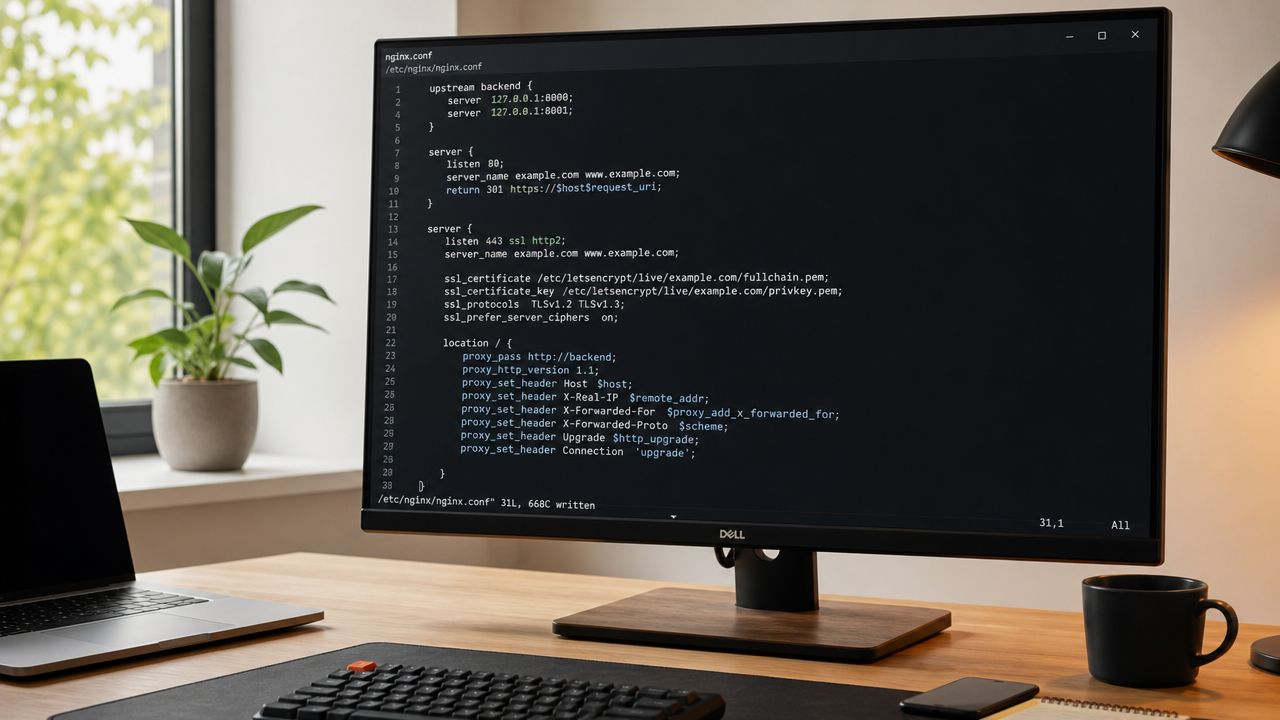
Un proxy inverso debe hacer bien unas pocas cosas: mantener estable el nombre de host público, pasar los detalles originales de la petición al upstream y fallar de forma limpia cuando un nodo deja de estar sano. La sintaxis siguiente es sencilla a propósito, pero refleja el patrón básico que muchos equipos usan antes de añadir terminación TLS, comprobaciones de estado activas y una política de timeouts más estricta.
upstream wordpress_backend {
    server wordpress-app-1;
    server wordpress-app-2;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://wordpress_backend;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Lo importante no es el fragmento en sí. El proxy debe conservar suficiente contexto para que WordPress, PHP, los logs, las herramientas de seguridad y las cachés upstream tomen decisiones correctas. Si Host o X-Forwarded-Proto son incorrectos, WordPress empieza a generar URL erróneas, las redirecciones entran en bucle y los problemas de contenido mixto aparecen enseguida tras el cambio.
Ajustes específicos de WordPress que los equipos suelen pasar por alto
Una configuración de WordPress con varios nodos suele fallar en los sitios aburridos.
Configure la URL del sitio y la URL de inicio con el dominio público que está detrás del balanceador, no con un servidor de aplicaciones concreto ni con una IP sin más. En la práctica, muchos equipos también definen estos valores en wp-config.php para que no puedan desviarse en la base de datos durante una migración apresurada. Es especialmente útil cuando varios entornos comparten el mismo proceso de despliegue.
Las subidas no deberían vivir solo en el disco local. Use almacenamiento de objetos o un sistema de archivos compartido en el que confíe a nivel operativo. El almacenamiento de objetos suele ser la opción más limpia, porque elimina las tareas de sincronización de archivos y las diferencias entre nodos, pero también añade dependencias de plugins y cambia el comportamiento de las URL de los medios, las cabeceras de caché y el procesamiento de imágenes. Los sistemas de archivos compartidos pueden funcionar, aunque con cargas con muchas escrituras suelen convertirse en la parte más lenta y menos predecible de la pila.
Cron exige la misma disciplina. Configure define('DISABLE_WP_CRON', true); y ejecute las tareas programadas desde un único planificador controlado. Si cada nodo web puede activar cron a partir del tráfico real, las tareas duplicadas y las condiciones de carrera se convierten en un problema habitual de producción en lugar de un caso límite.
Un modelo operativo compacto tiene este aspecto:
| Área | Opción práctica | Por qué ayuda |
|---|---|---|
| Subidas | S3 o un almacenamiento de objetos equivalente | Mantiene los medios coherentes entre nodos |
| Base de datos | Servicio relacional gestionado | Reduce la carga de administración y mejora la capacidad de recuperación |
| Caché | Servicio Redis compartido | Evita un estado de objetos fragmentado |
| Cron | Planificador externo del sistema | Evita la ejecución duplicada de tareas en varios nodos |
Constrúyala y rómpala antes de producción
La primera prueba real es el fallo, no la velocidad de la página. Saque un nodo de aplicación de la rotación. Detenga PHP-FPM en otro. Purgue la caché durante un flujo de publicación editorial. Ejecute una actualización de un plugin y confirme que la administración, los inicios de sesión, las subidas y las tareas asíncronas siguen comportándose igual. Si estas pruebas son difíciles de ejecutar, la arquitectura todavía es demasiado frágil.
Un buen sitio de staging de WordPress para probar los cambios de balanceo de carga da a los equipos un lugar donde ensayar los pasos del cambio, la reversión, el comportamiento de la purga de caché y la sustitución de nodos sin poner en riesgo los ingresos ni los flujos de publicación.
Trate el despliegue como gestión de la configuración, no como trabajo manual en los servidores. Incorpore las mismas versiones de Nginx, PHP, WordPress y plugins en cada nodo. Si un servidor necesita un arreglo manual para seguir en rotación, el clúster ya se está saliendo de la especificación.
Optimización del rendimiento, la seguridad y el coste
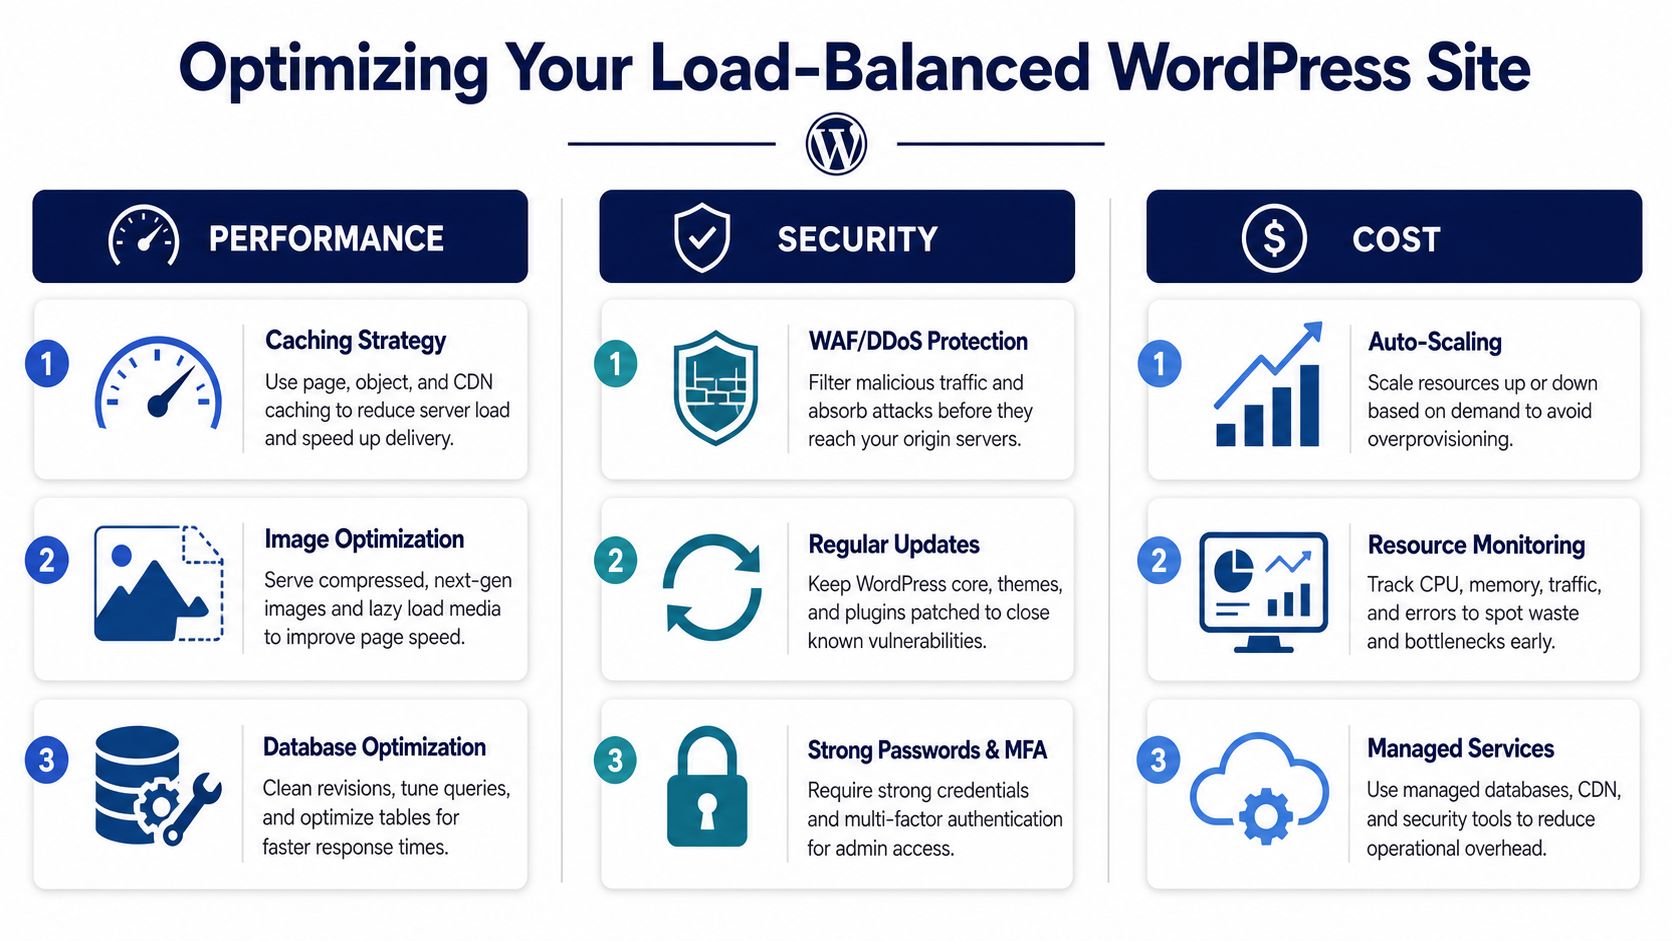
El balanceo de carga no hace que una pila WordPress sea eficiente por sí solo. En sitios más pequeños o mal ajustados, puede añadir saltos de red, complejidad en la caché y coste operativo antes de resolver el principal cuello de botella.
Disciplina de rendimiento
Una vez que un clúster está en producción, el rendimiento suele depender menos del balanceador en sí y más del comportamiento de la caché, del margen de workers de PHP y de los patrones de consultas a la base de datos. Por eso los equipos maduros definen las reglas de caché de forma explícita en lugar de tratar la caché como un ajuste de un plugin.
Una configuración por defecto sensata es sencilla. Cachee los recursos estáticos de forma agresiva. Use TTL más cortos para las páginas que cambian a menudo. Purgue la caché con las actualizaciones de contenido, los cambios de productos y los eventos editoriales clave. Los tiempos exactos dependen de la aplicación, pero el principio operativo es el mismo: el contenido estable debe mantenerse fuera de PHP y MySQL el mayor tiempo posible.
La monitorización exige el mismo nivel de disciplina. Vigile a la vez el tiempo de respuesta, la saturación de CPU, el agotamiento de workers de PHP, la tasa de aciertos de caché y la latencia de la base de datos. La disponibilidad por sí sola oculta muchos problemas. Un sitio puede seguir técnicamente disponible mientras el checkout se ralentiza, las acciones de administración se atascan o el tráfico autenticado empieza a hacer cola detrás de peticiones sin caché.
Fije los umbrales de alerta lo bastante pronto como para que el equipo pueda actuar antes de que los usuarios lo noten. En muchos entornos WordPress, eso significa alertar ante una presión sostenida sobre los recursos y una latencia creciente de la aplicación, sin esperar a una caída completa.
Postura de seguridad
Una configuración de WordPress con balanceo de carga debe reducir la superficie de ataque. El punto de entrada público es el balanceador y la capa de seguridad. Los nodos de aplicación no deben aceptar tráfico directo de internet salvo que exista un motivo operativo concreto y controles compensatorios.
Mantenga privadas las instancias de origen siempre que pueda. Restrinja el acceso de gestión. Termine TLS de forma limpia. Si el sitio tiene un perfil de exposición relevante, coloque un WAF delante del balanceador y asegúrese de que las reglas de acceso al origen solo confían en esa ruta. Esto importa todavía más en WooCommerce, en las plataformas de membresía y en los equipos editoriales que trabajan en wp-admin desde muchas ubicaciones.
Un punto de entrada centralizado también hace más limpia la respuesta a incidentes. Los logs, los límites de peticiones, los controles de IP y el filtrado de bots funcionan mejor cuando el tráfico entra por una única ruta controlada.
Control de costes
Los equipos a menudo sobredimensionan. Un clúster de tres nodos con base de datos gestionada, Redis, almacenamiento de objetos, CDN, WAF y autoescalado puede ser la respuesta correcta para una plataforma crítica para el negocio. También es una respuesta cara a un problema que quizá podría haberse resuelto con caché de página completa, un mejor ajuste de las consultas o más capacidad en un único nodo.
El control de costes empieza por ajustar la arquitectura a la carga de trabajo. Si el tráfico tiene picos pero es mayoritariamente anónimo, invierta primero en caché y en descarga a la CDN. Si el tráfico es alto de forma constante y procede de usuarios autenticados, dedique más atención a la concurrencia de PHP, la eficiencia de la caché de objetos y la capacidad de la base de datos. Si la plataforma tiene requisitos estrictos de disponibilidad, la redundancia puede justificar un gasto mayor incluso antes de que el uso medio parezca alto.
Una lista de comprobación operativa práctica tiene este aspecto:
- Mida la saturación, no solo la disponibilidad: El aumento de la latencia, los grupos de workers de PHP llenos y las tasas bajas de aciertos de caché suelen aparecer antes de una caída.
- Use servicios gestionados donde eliminen trabajo pesado real: Las capas gestionadas de base de datos y caché suelen merecer el sobrecoste si el equipo no quiere encargarse de las copias de seguridad, la conmutación por error, los parches y la recuperación.
- Sea honesto con la arquitectura: Si el almacenamiento compartido, la comunicación entre nodos o los fallos de caché están elevando la latencia, añadir más nodos de aplicación suele aumentar el coste más rápido que el rendimiento.
- Revise con regularidad el comportamiento del autoescalado: Unos umbrales mal definidos pueden escalar demasiado tarde durante los picos de tráfico o con demasiada frecuencia porque la aplicación es ineficiente.
Las mejores plataformas WordPress con balanceo de carga no son las más grandes. Son aquellas en las que cada capa añadida tiene una función clara, un beneficio medible y un coste operativo que el equipo entiende.
Su ruta de migración hacia una arquitectura escalable
Trate la migración como un proyecto de ingeniería por fases, no como un cambio de hosting.
Empiece midiendo el rendimiento de la plataforma actual para saber si el problema de fondo es la CPU, los workers de PHP, la contención en la base de datos, los fallos de caché o la E/S de archivos. Después, construya el entorno de destino en staging y valide primero las partes difíciles: el comportamiento del inicio de sesión, la coherencia de los medios, los flujos de administración, las tareas programadas y la invalidación de la caché.
A continuación, ejecute pruebas controladas contra la nueva pila y ensaye los fallos. Saque un nodo de la rotación. Confirme que el sitio sigue funcionando bien. Pruebe la publicación de contenido y cualquier flujo de checkout o de membresía en condiciones realistas. Solo entonces debería planificar el cambio.
Las migraciones más limpias usan un lanzamiento por fases con una monitorización estrecha justo después de mover el tráfico. Eso da al equipo margen para detectar problemas de estado, caché o enrutamiento antes de que se conviertan en incidentes de negocio.
El balanceo de carga en WordPress merece la pena cuando la plataforma se ha quedado pequeña para un solo nodo. Es un error cuando se usa como sustituto de la ingeniería básica de rendimiento. La diferencia está en la disciplina de arquitectura.
Si su equipo está planificando el paso a WordPress en clúster, WooCommerce con mucho tráfico o una pila empresarial más resiliente, IMADO puede ayudarle a diseñar la arquitectura, validar la ruta de migración y construir una plataforma que sus editores e ingenieros puedan operar.