Większość porad dotyczących skalowania WordPressa od razu przeskakuje do load balancera. Często to zły ruch.
Load balancer rozwiązuje konkretną klasę problemów. Pomaga, gdy jeden serwer aplikacji nie jest w stanie niezawodnie przyjąć ruchu, gdy potrzebujesz redundancji albo gdy pojedyncza maszyna stała się ryzykiem operacyjnym. Jednak w wielu serwisach zbyt wczesne dodanie load balancera daje więcej ruchomych części, więcej scenariuszy awarii i większe opóźnienia niż realnej wartości.
Lepsze pytanie nie brzmi „Jak dodać równoważenie obciążenia do WordPressa?”, tylko „Jakie wąskie gardło próbujemy usunąć?”. W mniejszych projektach solidne cache’owanie stron, cache obiektów, porządki w bazie danych, przeniesienie obrazów na zewnętrzny storage i dyscyplina w doborze wtyczek zwykle rozwiązują problem szybciej i przy mniejszej złożoności. W WordPressie klasy enterprise przychodzi jednak moment, w którym rozproszenie poziome staje się koniecznością. Wtedy architektura zaczyna mieć większe znaczenie niż jednorazowe strojenie.
Kiedy naprawdę potrzebujesz równoważenia obciążenia w WordPressie
Popularne założenie jest proste: więcej serwerów to lepsza wydajność. W praktyce to tak nie działa.
W serwisach WordPress o mniejszym ruchu równoważenie obciążenia może pogorszyć wydajność. SpinupWP zauważa, że konfiguracje jednoserwerowe są wydajniejsze od konfiguracji z load balancerem mniej więcej do 8 jednoczesnych użytkowników, a dodatkowy przeskok sieciowy może spowalniać żądania, gdy wykorzystanie CPU jest poniżej 20% (analiza load balancerów SpinupWP). To niuans, który większość ogólnych poradników pomija.
Kiedy load balancer jest przedwczesny
Jeśli Twój serwis to głównie treści, które da się cache’ować, zacznij gdzie indziej. Jeden dobrze dostrojony serwer z pełnym cache’owaniem stron, cache obiektów Redis, CDN i zdyscyplinowanym użyciem wtyczek zwykle wypadnie lepiej niż rozproszony stos, którego nie zaprojektowano pod kątem stanu, storage’u i spójności cache.
Prawdopodobnie nie potrzebujesz jeszcze równoważenia obciążenia w WordPressie, jeśli Twoje obecne problemy wyglądają tak:
- Chybienia cache przez źle działające wtyczki: Jedna wtyczka omija cache stron i cały stos wydaje się wolny.
- Rozdęte media i wolne dostarczanie zasobów: Duże pliki i niezoptymalizowane obrazy nasycają I/O albo przepustowość.
- Dryf bazy danych: Autoładowane opcje, przeterminowane transienty i hałaśliwe zapytania dokładają zbędną pracę do każdego żądania.
- Prostota operacyjna jest ważniejsza: Twój zespół potrzebuje niezawodności i szybkiego wycofania zmian, a nie większej powierzchni systemu.
Dla zespołów, które decydują, czy najpierw inwestować w architekturę skalowania, czy w podstawową pracę nad wydajnością, to zwykle moment, w którym opłaca się przegląd doświadczonego inżyniera. Rozwiązania WordPress dla dużych firm są najskuteczniejsze, gdy zaczynają się od faktycznego wąskiego gardła, a nie od najmodniejszego wzorca.
Praktyczna zasada: Jeśli cache i higiena bazy danych nie zostały zrobione porządnie, dodanie load balancera zwykle ukrywa problem, zamiast go naprawić.
Kiedy staje się konieczny
Równoważenie obciążenia zaczyna mieć sens, gdy dostępność i współbieżność są ważniejsze niż prostota architektury. Pomyśl o premierach produktów, dużych kampaniach WooCommerce, platformach członkowskich z częstym ruchem zalogowanych użytkowników, serwisach wydawców ze skokami ruchu albo stronach firmowych, które nie mogą sobie pozwolić na awarię pojedynczego węzła.
W takich przypadkach wymaganiem nie jest sama szybkość. Chodzi o odporność. Potrzebujesz, żeby jeden węzeł mógł paść bez pociągania za sobą całej platformy. Potrzebujesz health checków, przewidywalnego routingu i infrastruktury, która przyjmie skoki ruchu bez wymuszania awaryjnych zmian pod presją.
Wtedy równoważenie obciążenia w WordPressie przestaje być opcją i staje się infrastrukturą.
Jak działa architektura równoważenia obciążenia
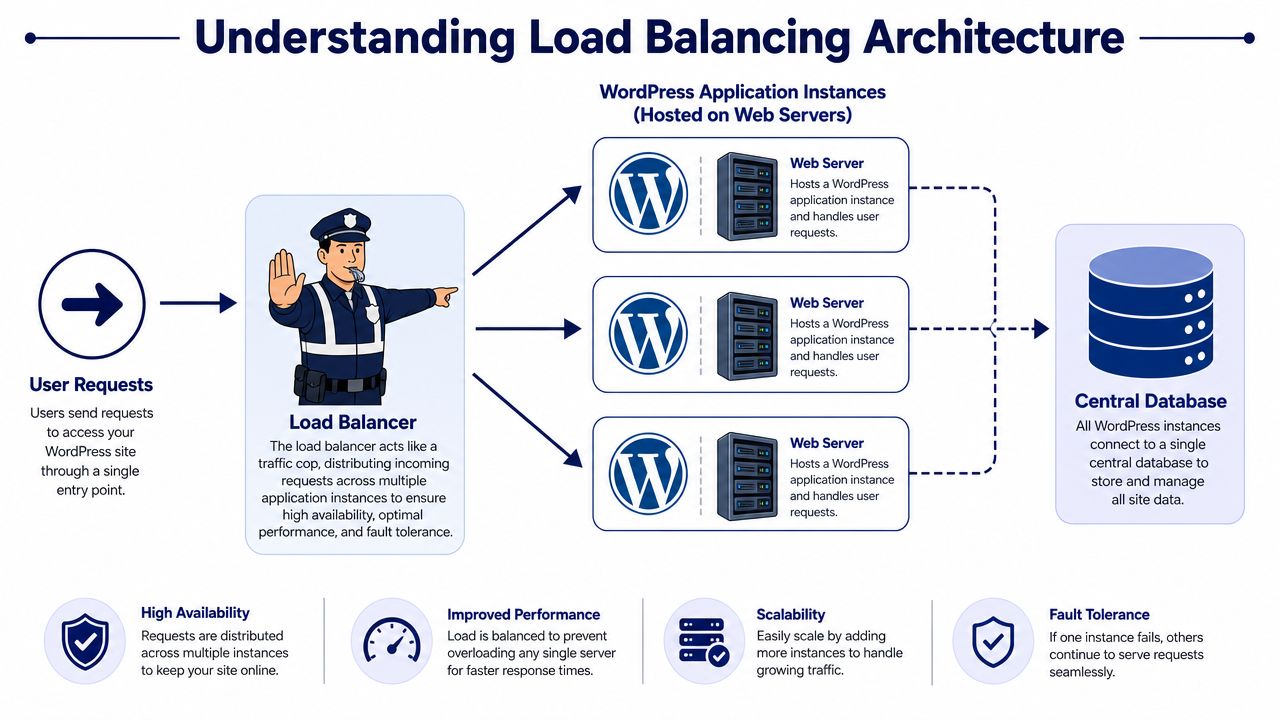
Gotowa do produkcji konfiguracja WordPressa z równoważeniem obciążenia ma cztery ruchome części. Load balancer z przodu, za nim kilka bezstanowych węzłów aplikacji, współdzielony dostęp do uploadów i centralna warstwa cache, z której może korzystać każdy węzeł.
Brzmi to prosto, ale to także moment, w którym mniejsze instalacje WordPressa stają się wolniejsze, bardziej kruche i droższe. Architektura pomaga tylko wtedy, gdy każda warstwa rozwiązuje realne wąskie gardło. Jeśli ruch nadal w większości da się cache’ować, a jeden dostrojony węzeł sobie z nim radzi, rozproszona infrastruktura dodaje przeskoki sieciowe, więcej punktów awarii i więcej pracy operacyjnej bez większego zysku.
Cztery elementy, które mają znaczenie
Każdy komponent ma konkretne zadanie:
- Load balancer lub reverse proxy przyjmuje ruch przychodzący, sprawdza stan backendów i wysyła żądania do węzła, który może je obsłużyć.
- Węzły aplikacji WordPress uruchamiają PHP, przetwarzają żądania spoza cache i powinny być traktowane jak wymienne jednostki robocze, a nie długowieczne „pupile”.
- Współdzielony storage lub offload mediów udostępnia uploady każdemu węzłowi, dzięki czemu pliki nie zależą od lokalnego dysku.
- Centralny cache obiektów daje wszystkim węzłom ten sam widok obiektów i transientów w cache, zamiast pozwalać każdemu serwerowi budować własny, odizolowany cache.
Ten ostatni punkt często bywa pomijany. Zespoły dodają drugi lub trzeci węzeł WWW, ale zostawiają cache i obsługę plików lokalnie. Skutkiem jest niespójne zachowanie, które pojawia się dopiero pod obciążeniem. Jeden odwiedzający dostaje świeży wpis w cache obiektów. Inny trafia na inny węzeł i go nie znajduje. Redaktor wgrywa plik, a jeden serwer widzi go wcześniej niż pozostałe. WordPress może działać w takim stanie, ale nie działa przewidywalnie.
Co naprawdę robi każda warstwa
Reverse proxy robi więcej niż rozdzielanie ruchu metodą round-robin. W poważnej konfiguracji obsługuje health checki, zachowuje właściwe nagłówki przekazywania, terminuje TLS, jeśli pasuje to do projektu, i usuwa niesprawne węzły, zanim zauważą to użytkownicy. Nginx, HAProxy i zarządzane load balancery w chmurze potrafią to wszystko. Właściwy wybór zależy mniej od listy funkcji, a bardziej od tego, kto będzie go utrzymywał o drugiej w nocy.
Węzły aplikacji wymagają dyscypliny. Nie powinny trzymać na lokalnym dysku niczego krytycznego dla biznesu i nie powinny zależeć od lepkiego stanu, chyba że świadomie wybrałeś ten kompromis. Jeśli wymiana uszkodzonego węzła wymaga ręcznej synchronizacji plików albo specjalnego sprzątania, architektura już działa przeciwko Tobie.
Storage to miejsce, w którym pospieszne wdrożenia zwykle się sypią. WordPress oczekuje spójnego widoku wp-content/uploads, a niektóre wtyczki nadal zakładają dostęp do lokalnego systemu plików. Możesz to rozwiązać współdzielonym storage’em sieciowym albo przeniesieniem mediów do object storage i dostosowaniem stosu wokół tego. Żadna z opcji nie jest darmowa. Sieciowe systemy plików mogą dodawać opóźnienia i problemy z blokadami. Offload mediów zmniejsza to ryzyko, ale kompatybilność wtyczek i przepływy pracy redakcji trzeba przetestować.
Ten sam wzorzec pojawia się na większych współdzielonych platformach, zwłaszcza w architekturach WordPress Multisite. Gdy wiele witryn, redaktorów i wtyczek zależy od tej samej platformy, niespójny stan plików i rozjeżdżający się cache na poszczególnych węzłach szybko zamieniają się w zgłoszenia do supportu.
Zdrowy stos WordPressa z równoważeniem obciążenia to mniej dodawanie serwerów, a bardziej usuwanie lokalnych założeń. To jest zmiana architektoniczna, która ma znaczenie.
Wybór architektury równoważenia obciążenia
Nie ma jednej „najlepszej” architektury równoważenia obciążenia dla WordPressa. Jest kilka poprawnych wzorców, a każdy z nich inaczej wyważa kontrolę, koszt i nakład pracy na utrzymanie.
Zły wybór zwykle wynika z optymalizowania tylko jednej zmiennej. Zespoły wybierają najtańszą konfigurację i dziedziczą duży narzut operacyjny. Albo wybierają opcję najbardziej zarządzaną, a potem odkrywają, że nie mogą dostroić routingu ani obserwowalności tak, jak potrzebują. Właściwy projekt zależy od tego, kto będzie go utrzymywał po starcie, a nie tylko od tego, kto potrafi go zbudować.
Trzy typowe wzorce
Większość stosów WordPressa klasy enterprise trafia do jednej z tych kategorii:
| Architektura | Najlepsza dla | Złożoność | Koszt | Kontrola |
|---|---|---|---|---|
| Zarządzany load balancer w chmurze | Zespołów, które chcą zarządzanej infrastruktury i łatwiejszego skalowania | Umiarkowana | Umiarkowany do wysokiego | Umiarkowana |
| Własne proxy z Nginx lub HAProxy | Zespołów z mocnymi kompetencjami DevOps i niestandardowymi potrzebami routingu | Wysoka | Zmienny | Wysoka |
| Rozkład ruchu oparty na CDN | Serwisów z dużą ilością treści, które mogą przenieść większość ruchu na brzeg sieci | Niższa na originie, ale ograniczona przy pełnym równoważeniu aplikacji | Zmienny | Niższa w zakresie zachowania originu |
Zarządzane load balancery w chmurze
Zarządzane load balancery w chmurze to zwykle najbezpieczniejszy domyślny wybór dla zespołów enterprise. Dają health checki, obsługę TLS, pule backendów i integrację z autoskalowaniem, nie wymagając od zespołu niańczenia kolejnej krytycznej usługi.
Są szczególnie przydatne, gdy infrastruktura już opiera się na usługach zarządzanych w warstwie bazy danych i storage’u. Zaletą jest mniejsze obciążenie operacyjne. Wadą jest mniej szczegółowe strojenie, zwłaszcza jeśli potrzebujesz bardzo specyficznej logiki routingu, niestandardowego buforowania albo nietypowej obsługi nagłówków.
Własne proxy
Nginx i HAProxy dają głęboką kontrolę. Jeśli potrzebujesz niestandardowych reguł upstream, zaawansowanego przełączania awaryjnego albo specyficznej interakcji przepisywania adresów z cache, własna warstwa proxy daje inżynierom pole do ukształtowania platformy dokładnie tak, jak chcą.
Ta kontrola wiąże się z odpowiedzialnością:
- Odpowiadasz za łatki: Proxy to kolejna usługa produkcyjna, którą trzeba aktualizować i zabezpieczać.
- Odpowiadasz za obserwowalność: Logi, metryki, alerty i debugowanie upstreamów stają się Twoim problemem.
- Odpowiadasz za odporność: Jeśli warstwa proxy jest niedoprojektowana, staje się pojedynczym punktem awarii.
Dla zespołów, które już obsługują platformy kontenerowe lub własny hosting WordPressa, to może być właściwa droga. Dla zespołów bez dedykowanego wsparcia infrastrukturalnego często staje się kosztownym rozproszeniem uwagi.
Podejścia oparte na CDN
CDN może przyjąć ogromne ilości ruchu statycznego i cache’owalnego, co oznacza, że do originu dociera znacznie mniej żądań. To cenne, ale to nie to samo co pełne równoważenie obciążenia aplikacji.
CDN jest najmocniejszy, gdy serwis ma dużo treści, globalną publiczność i da się go agresywnie cache’ować. Jest słabszy, gdy żądania są dynamiczne, spersonalizowane albo ściśle powiązane z sesjami zalogowanych użytkowników. Jeśli Twój profil ruchu to głównie zalogowani klienci WooCommerce lub członkowie, CDN pomaga, ale nie zastąpi dobrej architektury originu.
Wybierz architekturę, którą Twój zespół jest w stanie obsługiwać w zwykły wtorek, a nie tylko w tygodniu premiery.
Obsługa sesji i stanu bazy danych
Zarządzanie stanem to punkt awarii, który najczęściej widzę w projektach równoważenia obciążenia WordPressa.
Jednoserwerowa instalacja WordPressa uchodzi na sucho z założeniami, które przestają działać w chwili dodania drugiego węzła aplikacji. Żądania odbijają się między serwerami. Jeden węzeł ma dane sesji użytkownika w pamięci, drugi nie. Jeden węzeł widzi niedawno zapisany w cache obiekt, inny serwuje nieaktualne dane. Jeśli uploady, wpisy cache albo dane podobne do sesji żyją na lokalnym dysku lub w lokalnej pamięci, platforma przestaje zachowywać się jak jedna aplikacja.
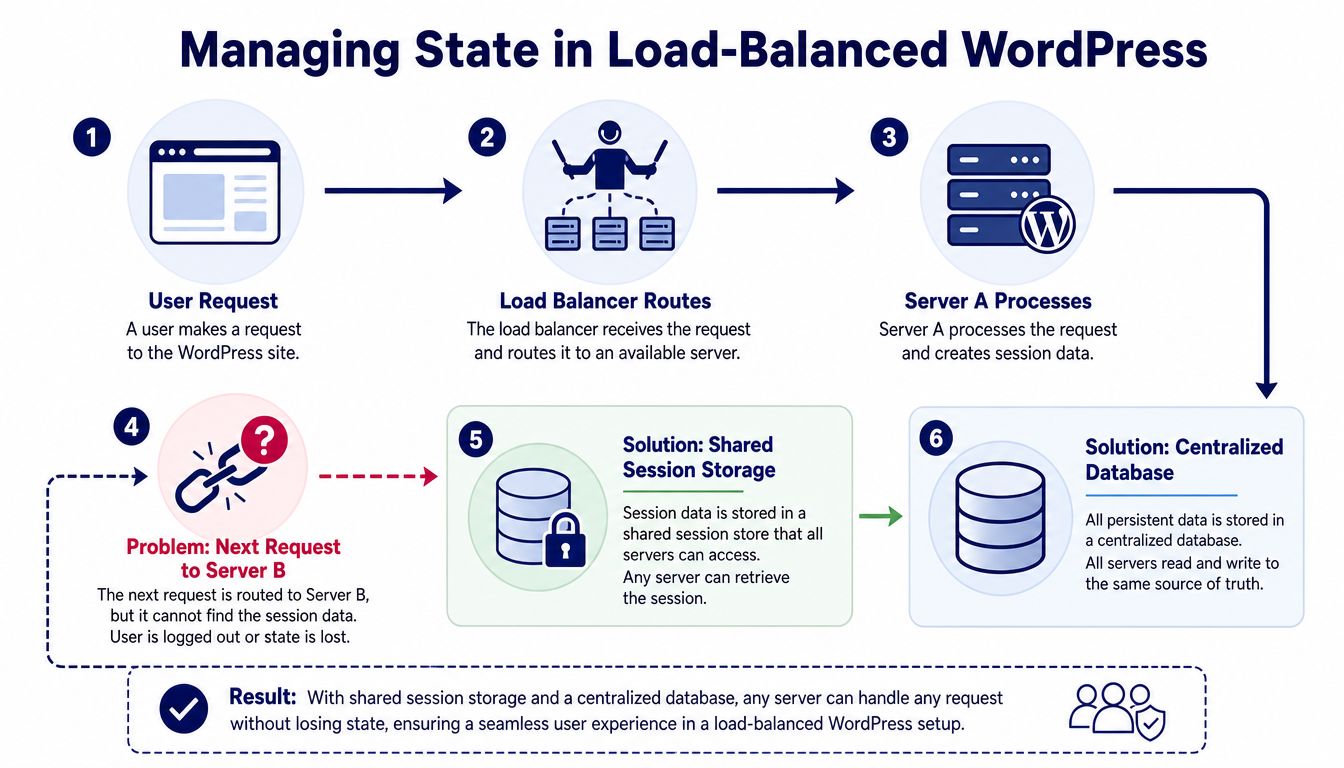
To również powód, dla którego równoważenie obciążenia jest często złym pierwszym krokiem w mniejszych serwisach WordPress. Dodawanie kolejnych węzłów WWW przed naprawą strategii cache, wydajności bazy danych i przechowywania plików zwykle dokłada opóźnień i ryzyka operacyjnego, nie rozwiązując głównego wąskiego gardła.
Dlaczego sticky sessions to tymczasowy kompromis
Sticky sessions mogą ograniczyć widoczne dla użytkownika awarie, kierując tego samego odwiedzającego z powrotem do tego samego węzła backendu. Może to pomóc przy ruchu zalogowanych użytkowników, koszykach, procesach członkowskich i starszych wtyczkach, które zakładają lokalny stan sesji.
To nadal kompromis, a nie czysty projekt.
Kompromisy są przewidywalne:
- Przełączanie awaryjne słabnie: Jeśli przypisany węzeł padnie, użytkownik może stracić stan koszyka, ciągłość logowania albo rozpoczęte działania.
- Rozkład ruchu staje się nierówny: Aktywni użytkownicy pozostają przypięci do konkretnych węzłów, co tworzy gorące punkty.
- Diagnozowanie problemów jest trudniejsze: Sporadyczne błędy stają się zależne od węzła i trudniejsze do odtworzenia.
- Skalowanie traci efektywność: Dodawanie serwerów niewiele pomaga, jeśli duża część ruchu nadal jest przyklejona do kilku węzłów.
Używam sticky sessions tylko wtedy, gdy aplikacji nie da się w krótkim terminie uczynić bezstanową. Są przydatne w trakcie migracji. Nie są stanem docelowym.
Jak wygląda czystsza architektura
Dla WordPressa, który potrzebuje prawdziwego skalowania poziomego, lepszy wzorzec jest prosty. Węzły WWW mają być bezstanowe. Trwałe dane trzymaj we współdzielonych systemach do tego zaprojektowanych.
W praktyce zwykle oznacza to:
- Jedną główną bazę danych do zapisów, aby wpisy, zamówienia, zmiany ustawień i działania administracyjne miały jedno źródło prawdy.
- Repliki do odczytu tam, gdzie pomagają, przy obciążeniach z przewagą odczytów, które tolerują opóźnienie replikacji.
- Współdzielony cache obiektów, np. Redis, aby dane transientów i cache obiektów były dostępne dla każdego węzła aplikacji.
- Współdzielony storage mediów, aby uploady nie były przywiązane do jednego serwera.
WP Farm mówi to samo z perspektywy hostingu. Współdzielony cache i przejrzysta topologia bazy danych zmniejszają pokusę traktowania wp-content jako warstwy stanu, co zwykle powoduje większą presję na I/O i więcej scenariuszy awarii, niż zespoły się spodziewają (WP Farm o równoważeniu obciążenia w hostingu WordPress).
Przy replikach do odczytu warto zachować jedną ostrożność. Pomagają w serwisach z dużą ilością treści i dużym wolumenem odczytów, ale mogą szkodzić e-commerce i platformom członkowskim, jeśli opóźnienie repliki powoduje odczyt nieaktualnych danych po zapisie. Klient aktualizuje adres albo składa zamówienie, a następne żądanie czyta z opóźnionej repliki i pokazuje stare dane. To nie jest teoretyczny przypadek brzegowy. To częste źródło dziwnych błędów w WooCommerce.
W sklepach praca nad bazą danych powinna odbyć się przed wdrożeniem równoważenia obciążenia albo równolegle z nim. Optymalizacja bazy danych WooCommerce zwykle daje bardziej mierzalne zyski niż dodawanie kolejnych węzłów PHP do nieefektywnego wzorca zapytań.
Pomaga tu praktyczny test. Jeśli wyłączenie jednego serwera aplikacji zepsułoby logowanie, koszyki, uploady albo procesy w panelu administracyjnym, platforma nie jest jeszcze gotowa na prawdziwe równoważenie obciążenia.
Szybka ilustracja pomaga wyjaśnić ten przepływ:
Jeśli jeden węzeł WWW nadal przechowuje unikalny stan sesji lub aplikacji, masz kilka serwerów, ale nie masz prawidłowo rozproszonej aplikacji WordPress.
Praktyczne wdrożenie i konfiguracja
Równoważenie obciążenia nie naprawi słabo zbudowanego WordPressa. Dodaje kolejną warstwę sterowania, kolejny punkt awarii i więcej pracy operacyjnej. W mniejszych serwisach ta dodatkowa warstwa może zwiększyć opóźnienia i utrudnić diagnozowanie problemów, nie rozwiązując głównego wąskiego gardła. Zanim ją wdrożysz, stos powinien być już na tyle bezstanowy, że dodanie lub usunięcie węzła zmienia pojemność, a nie zachowanie.
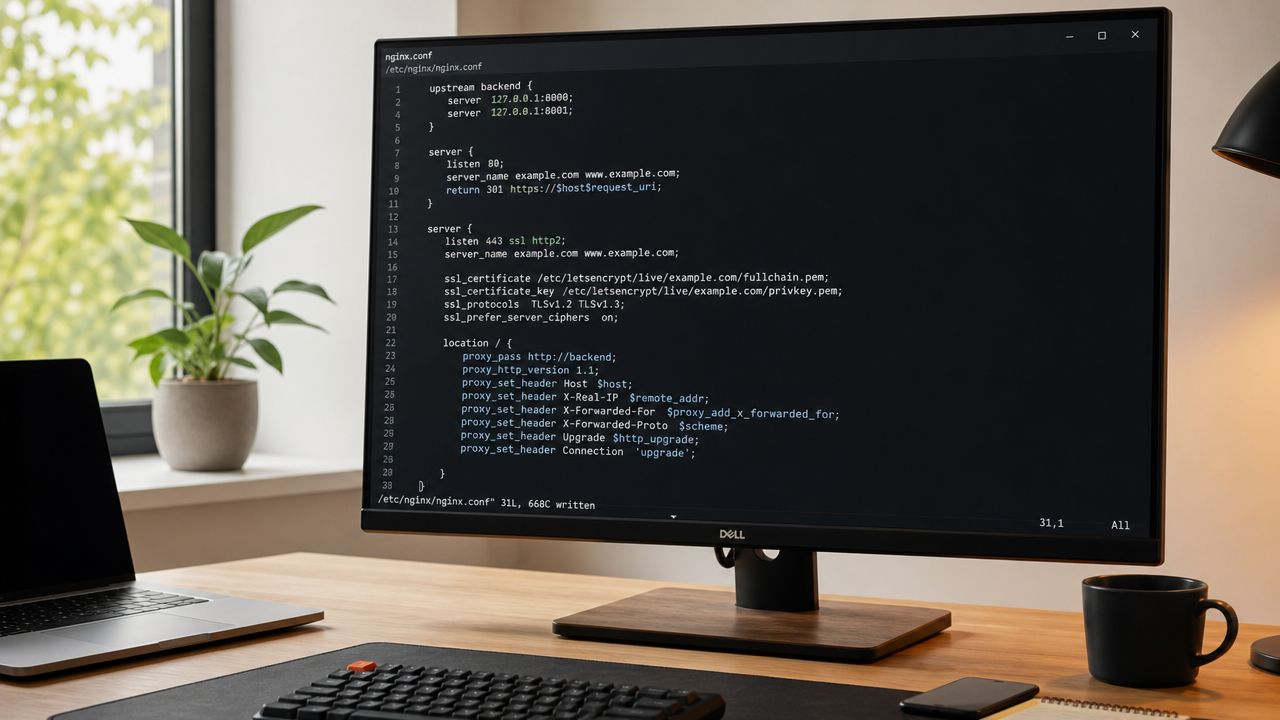
Prosty przykład reverse proxy w Nginx
Reverse proxy powinno dobrze robić kilka rzeczy. Utrzymywać stabilną publiczną nazwę hosta, przekazywać oryginalne szczegóły żądania do upstreamu i czysto obsługiwać sytuację, w której węzeł staje się niesprawny. Poniższa składnia jest celowo prosta, ale odzwierciedla bazowy wzorzec, którego wiele zespołów używa, zanim doda terminację TLS, aktywne health checki i bardziej rygorystyczną politykę timeoutów.
upstream wordpress_backend {
    server wordpress-app-1;
    server wordpress-app-2;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://wordpress_backend;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Liczy się nie sam fragment kodu. Proxy musi zachować wystarczająco dużo kontekstu, aby WordPress, PHP, logi, narzędzia bezpieczeństwa i cache upstream mogły podejmować poprawne decyzje. Jeśli Host albo X-Forwarded-Proto są błędne, WordPress zaczyna generować złe adresy URL, przekierowania się zapętlają, a problemy z mieszaną treścią szybko wychodzą po przełączeniu.
Ustawienia WordPressa, o których zespoły często zapominają
Wielowęzłowa konfiguracja WordPressa zwykle zawodzi w nudnych miejscach.
Ustaw adres witryny i adres strony głównej na publiczną domenę za load balancerem, a nie na pojedynczy serwer aplikacji czy surowy adres IP. W praktyce wiele zespołów definiuje te wartości także w wp-config.php, żeby nie mogły się rozjechać w bazie danych podczas pospiesznej migracji. Jest to szczególnie przydatne, gdy kilka środowisk korzysta z tego samego procesu wdrożeniowego.
Uploady nie powinny znajdować się wyłącznie na lokalnym dysku. Użyj object storage albo współdzielonego systemu plików, któremu ufasz operacyjnie. Object storage jest zwykle czystszą opcją, bo eliminuje zadania synchronizacji plików i rozjazd między węzłami, ale dodaje też zależności od wtyczek i zmienia zachowanie adresów URL mediów, nagłówków cache i przetwarzania obrazów. Współdzielone systemy plików mogą działać, choć przy obciążeniach z dużą liczbą zapisów często stają się najwolniejszą i najmniej przewidywalną częścią stosu.
Cron wymaga tej samej dyscypliny. Ustaw define('DISABLE_WP_CRON', true); i uruchamiaj zaplanowane zadania z jednego kontrolowanego harmonogramu. Jeśli każdy węzeł WWW może wywołać cron z ruchu na żywo, zduplikowane zadania i wyścigi stają się rutynowym problemem produkcyjnym zamiast przypadku brzegowego.
Zwięzły model operacyjny wygląda tak:
| Obszar | Praktyczny wybór | Dlaczego pomaga |
|---|---|---|
| Uploady | S3 lub równoważny object storage | Utrzymuje spójność mediów między węzłami |
| Baza danych | Zarządzana usługa relacyjna | Zmniejsza narzut administracyjny i ułatwia odtwarzanie |
| Cache | Współdzielona usługa Redis | Zapobiega rozdrobnieniu stanu obiektów |
| Cron | Zewnętrzny systemowy harmonogram zadań | Zapobiega wielokrotnemu wykonywaniu tych samych zadań na wielu węzłach |
Zbuduj i zepsuj przed produkcją
Pierwszym prawdziwym testem jest awaria, a nie szybkość strony. Wyłącz z ruchu jeden węzeł aplikacji. Zabij PHP-FPM na innym. Wyczyść cache w trakcie publikacji przez redaktora. Przeprowadź aktualizację wtyczki i sprawdź, czy panel administracyjny, logowanie, uploady i zadania asynchroniczne nadal zachowują się tak samo. Jeśli takie testy trudno przeprowadzić, architektura jest wciąż zbyt krucha.
Porządna strona stagingowa WordPressa do testowania zmian w równoważeniu obciążenia daje zespołom miejsce do przećwiczenia kroków przełączenia, wycofania zmian, zachowania czyszczenia cache i wymiany węzłów bez narażania przychodów czy procesów publikacji.
Traktuj wdrożenie jak zarządzanie konfiguracją, a nie ręczne dłubanie przy serwerach. Wbuduj te same wersje Nginx, PHP, WordPressa i wtyczek w każdy węzeł. Jeśli jeden serwer potrzebuje ręcznej poprawki, żeby pozostać w rotacji, klaster już odbiega od specyfikacji.
Optymalizacja wydajności, bezpieczeństwa i kosztów
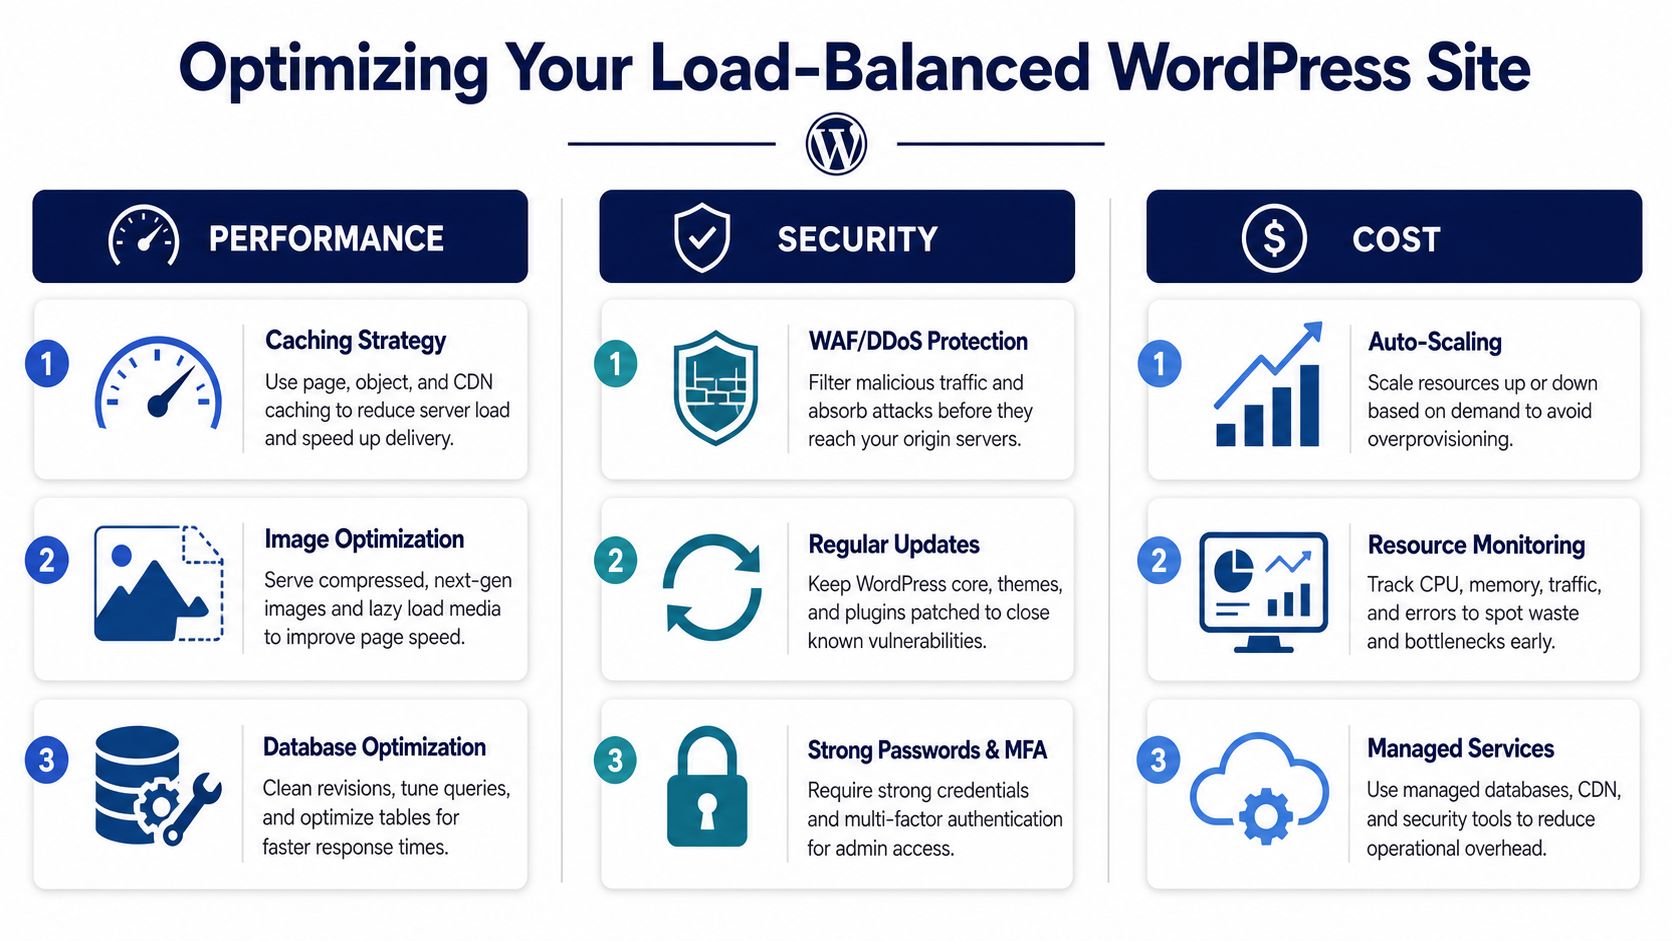
Równoważenie obciążenia samo z siebie nie czyni stosu WordPressa wydajnym. W mniejszych lub słabo dostrojonych serwisach może dodać przeskoki sieciowe, złożoność cache i koszty operacyjne, zanim naprawi główne wąskie gardło.
Dyscyplina wydajności
Gdy klaster działa, wydajność zwykle zależy mniej od samego load balancera, a bardziej od zachowania cache, zapasu workerów PHP i wzorców zapytań do bazy danych. Dlatego dojrzałe zespoły jawnie definiują reguły cache, zamiast traktować cache’owanie jak ustawienie wtyczki.
Rozsądne ustawienie domyślne jest proste. Agresywnie cache’uj zasoby statyczne. Stosuj krótsze TTL dla stron, które często się zmieniają. Czyść cache przy aktualizacjach treści, zmianach produktów i kluczowych wydarzeniach redakcyjnych. Dokładne czasy zależą od aplikacji, ale zasada działania pozostaje ta sama. Stabilne treści powinny jak najdłużej omijać PHP i MySQL.
Monitoring wymaga takiego samego poziomu dyscypliny. Obserwuj razem czas odpowiedzi, nasycenie CPU, wyczerpanie workerów PHP, współczynnik trafień cache i opóźnienia bazy danych. Sama dostępność ukrywa wiele bólu. Serwis może formalnie pozostać dostępny, podczas gdy checkout zwalnia, działania w panelu administracyjnym się zawieszają, a ruch zalogowanych użytkowników zaczyna czekać w kolejce za żądaniami spoza cache.
Ustaw progi alertów na tyle wcześnie, by zespół mógł zareagować, zanim odczują to użytkownicy. W wielu środowiskach WordPress oznacza to alarmowanie przy utrzymującej się presji na zasoby i rosnących opóźnieniach aplikacji, a nie czekanie na całkowitą awarię.
Postawa bezpieczeństwa
Konfiguracja WordPressa z równoważeniem obciążenia powinna zawężać powierzchnię ataku. Publicznym punktem wejścia jest load balancer i warstwa bezpieczeństwa. Węzły aplikacji nie powinny przyjmować bezpośredniego ruchu z internetu, chyba że istnieje konkretny powód operacyjny i wdrożono kontrole kompensujące.
Tam, gdzie to możliwe, utrzymuj instancje originu jako prywatne. Ograniczaj dostęp administracyjny. Czysto terminuj TLS. Jeśli serwis ma istotny profil ekspozycji, postaw WAF przed load balancerem i upewnij się, że reguły dostępu do originu ufają tylko tej ścieżce. Ma to jeszcze większe znaczenie w WooCommerce, na platformach członkowskich i w zespołach redakcyjnych pracujących w wp-admin z wielu lokalizacji.
Scentralizowany ruch przychodzący porządkuje też reagowanie na incydenty. Logi, limity żądań, kontrola IP i filtrowanie botów działają lepiej, gdy ruch wchodzi jedną kontrolowaną ścieżką.
Kontrola kosztów
Zespoły często budują ponad potrzeby. Trzywęzłowy klaster z zarządzaną bazą danych, Redisem, object storage, CDN, WAF i autoskalowaniem może być właściwą odpowiedzią dla platformy krytycznej dla biznesu. To także droga odpowiedź na problem, który być może dałoby się rozwiązać pełnym cache’owaniem stron, lepszym strojeniem zapytań albo większą pojemnością pojedynczego węzła.
Kontrola kosztów zaczyna się od dopasowania architektury do obciążenia. Jeśli ruch ma skoki, ale jest głównie anonimowy, najpierw zainwestuj w cache i odciążenie przez CDN. Jeśli ruch jest stale wysoki i pochodzi od zalogowanych użytkowników, poświęć więcej uwagi współbieżności PHP, efektywności cache obiektów i pojemności bazy danych. Jeśli platforma ma rygorystyczne wymagania dotyczące dostępności, redundancja może uzasadniać wyższe wydatki, nawet zanim średnie wykorzystanie zasobów wyda się wysokie.
Praktyczna lista kontrolna wygląda tak:
- Śledź nasycenie, a nie tylko dostępność: Rosnące opóźnienia, zapełnione pule workerów PHP i niski współczynnik trafień cache zwykle pojawiają się przed przestojem.
- Korzystaj z usług zarządzanych tam, gdzie usuwają realną harówkę: Zarządzane warstwy bazy danych i cache są często warte dopłaty, jeśli zespół nie chce odpowiadać za kopie zapasowe, przełączanie awaryjne, łatki i odtwarzanie.
- Bądź uczciwy wobec architektury: Jeśli opóźnienia napędzają współdzielony storage, komunikacja między węzłami albo chybienia cache, dodawanie węzłów aplikacji zwykle zwiększa koszty szybciej niż wydajność.
- Regularnie przeglądaj zachowanie autoskalowania: Złe progi mogą skalować za późno podczas skoków ruchu albo za często, bo aplikacja jest nieefektywna.
Najlepsze platformy WordPress z równoważeniem obciążenia nie są największe. To te, w których każda dodana warstwa ma jasne zadanie, mierzalną korzyść i koszt operacyjny zrozumiały dla zespołu.
Twoja ścieżka migracji do skalowalnej architektury
Traktuj migrację jak etapowy projekt inżynierski, a nie zmianę hostingu.
Zacznij od benchmarku obecnej platformy, żeby wiedzieć, czy źródłem problemu jest CPU, workery PHP, rywalizacja o bazę danych, chybienia cache czy I/O plików. Następnie zbuduj środowisko docelowe na stagingu i najpierw zweryfikuj trudne elementy: zachowanie logowania, spójność mediów, procesy w panelu administracyjnym, zaplanowane zadania i unieważnianie cache.
Potem przeprowadź kontrolowane testy nowego stosu i przećwicz awarię. Usuń węzeł z rotacji. Potwierdź, że serwis pozostaje sprawny. Przetestuj publikację treści i wszelkie procesy checkoutu lub członkostwa w realistycznych warunkach. Dopiero wtedy planuj przełączenie.
Najczystsze migracje korzystają z etapowego uruchomienia i ścisłego monitoringu tuż po przeniesieniu ruchu. Daje to zespołowi czas na wychwycenie problemów ze stanem, cache lub routingiem, zanim staną się incydentami biznesowymi.
Równoważenie obciążenia w WordPressie warto wdrożyć, gdy platforma wyrosła z pojedynczego węzła. Jest błędem, gdy służy jako zamiennik podstawowej inżynierii wydajności. Różnicę robi dyscyplina architektoniczna.
Jeśli Twój zespół planuje przejście na klastrowego WordPressa, WooCommerce o dużym ruchu albo bardziej odporny stos enterprise, IMADO może pomóc zaprojektować architekturę, zweryfikować ścieżkę migracji i zbudować platformę, którą Twoi redaktorzy i inżynierowie będą w stanie obsługiwać.