De flesta råd om att skala WordPress hoppar direkt till lastbalanseraren. Det är ofta fel drag.
En lastbalanserare löser en viss typ av problem. Den hjälper när en enda applikationsserver inte på ett tillförlitligt sätt klarar trafiken, när du behöver redundans eller när en enskild maskin har blivit en driftrisk. Men på många webbplatser ger en lastbalanserare som läggs till för tidigt fler rörliga delar, fler felsätt och mer latens än värde.
Den bättre frågan är inte ”Hur lägger vi till lastbalansering i WordPress?” utan ”Vilken flaskhals försöker vi ta bort?”. I mindre installationer löser stark sidcache, objektcache, databasstädning, avlastning av bilder och noggrann plugindisciplin oftast problemet snabbare och med mindre komplexitet. I WordPress för större organisationer kommer man ändå till en punkt där horisontell fördelning blir nödvändig. Det är då arkitekturen börjar betyda mer än finjustering.
När du verkligen behöver lastbalansering för WordPress
Det vanliga antagandet är enkelt: fler servrar betyder bättre prestanda. I praktiken fungerar det inte så.
På WordPress-webbplatser med mindre trafik kan lastbalansering försämra prestandan. SpinupWP påpekar att uppsättningar med en server presterar bättre än lastbalanserade uppsättningar upp till ungefär 8 samtidiga användare, och att det extra nätverkshoppet kan göra förfrågningar långsammare när CPU-användningen ligger under 20 % (SpinupWP:s analys av lastbalanserare). Det är den nyansen som de flesta allmänna guider hoppar över.
När en lastbalanserare är för tidig
Om din webbplats till största delen består av innehåll som kan cachas, börja någon annanstans. En enda välinställd server med helsidescache, Redis som objektcache, ett CDN och disciplinerad användning av plugins presterar ofta bättre än en distribuerad stack som inte har utformats med tanke på tillstånd, lagring och cachekonsistens.
Du behöver förmodligen inte lastbalansering för WordPress ännu om dina nuvarande problem ser ut så här:
- Cachemissar på grund av plugins som beter sig illa: Ett plugin kringgår sidcachen och får hela stacken att kännas långsam.
- Uppblåst media och långsam leverans av resurser: Stora uppladdningar och ooptimerade bilder belastar I/O eller bandbredd till max.
- Databasförfall: Autoladdade alternativ, utgångna transienter och onödiga frågor lägger till undvikbart arbete i varje förfrågan.
- Enkel drift är viktigare: Ditt team behöver tillförlitlighet och snabb återställning, inte en större yta att underhålla.
För team som ska avgöra om de först ska investera i skalningsarkitektur eller i grundläggande prestandaarbete är det här oftast punkten där en granskning av en erfaren expert lönar sig. WordPress-lösningar för företag fungerar bäst när de utgår från den faktiska flaskhalsen och inte från det mest populära mönstret.
Tumregel: Om cachning och databashygien inte har gjorts ordentligt döljer en ny lastbalanserare oftast problemet i stället för att lösa det.
När det blir nödvändigt
Lastbalansering börjar bli meningsfullt när tillgänglighet och samtidighet betyder mer än en enkel arkitektur. Tänk på produktlanseringar, stora WooCommerce-kampanjer, medlemsplattformar med mycket inloggad trafik, publicistsajter med trafiktoppar eller företagswebbplatser som inte har råd med att en enda nod fallerar.
I de fallen handlar kravet inte bara om hastighet. Det handlar om motståndskraft. Du behöver att en nod kan fallera utan att dra med sig hela plattformen. Du behöver hälsokontroller, förutsägbar routning och infrastruktur som klarar toppar utan att tvinga fram akuta ändringar under press.
Det är då lastbalansering för WordPress slutar vara valfritt och blir infrastruktur.
Så fungerar arkitekturen för lastbalansering
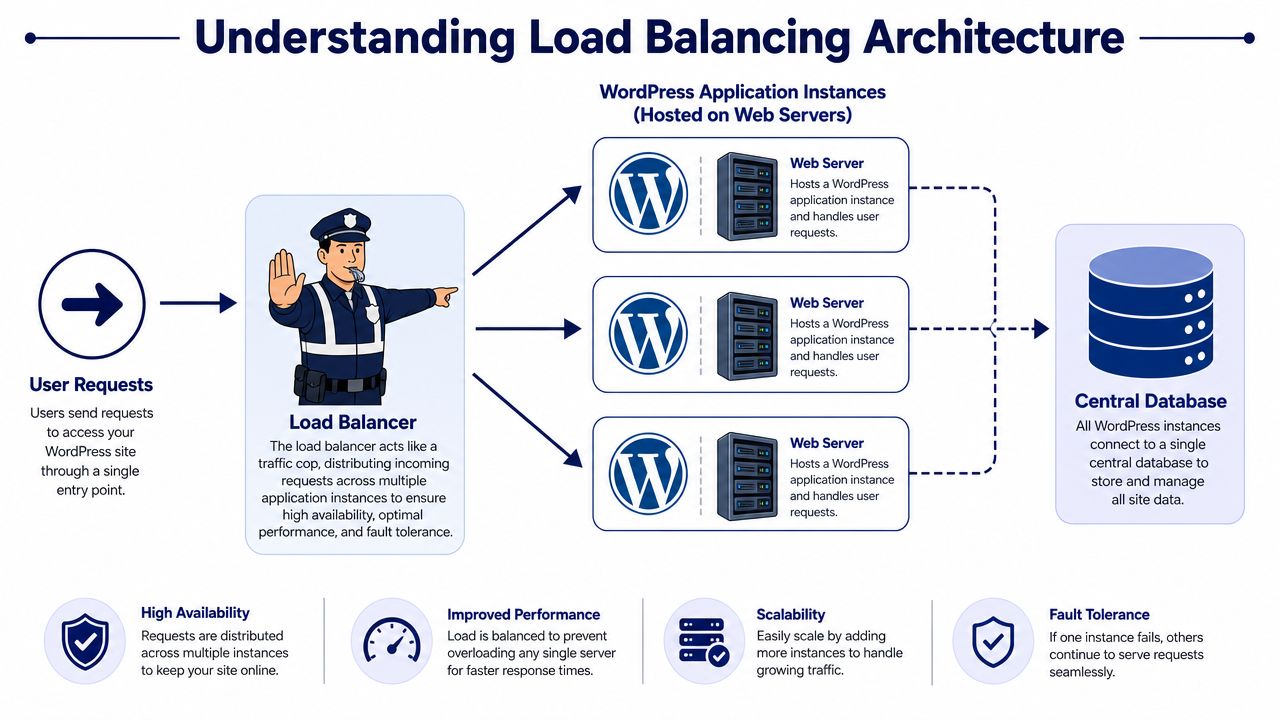
En produktionsklar, lastbalanserad WordPress-uppsättning har fyra rörliga delar: en lastbalanserare framför, flera tillståndslösa applikationsnoder bakom den, delad åtkomst till uppladdningar och ett centralt cachelager som alla noder kan använda.
Det låter okomplicerat, men det är också här mindre WordPress-installationer blir långsammare, skörare och dyrare. Arkitekturen hjälper bara om varje lager löser en verklig flaskhals. Om trafiken fortfarande till största delen kan cachas och en välinställd nod klarar den, ger distribuerad infrastruktur fler nätverkshopp, fler felpunkter och mer driftarbete utan någon större vinst.
De fyra delarna som spelar roll
Varje komponent har ett specifikt jobb:
- Lastbalanseraren eller den omvända proxyn tar emot inkommande trafik, kontrollerar backendarnas hälsa och skickar förfrågningar till en nod som kan hantera dem.
- WordPress-applikationsnoderna kör PHP, behandlar förfrågningar som inte finns i cachen och ska behandlas som utbytbara arbetare, inte som långlivade ”husdjur”.
- Delad lagring eller avlastning av media gör uppladdningar tillgängliga för alla noder så att filerna inte är beroende av den lokala disken.
- En central objektcache ger alla noder samma bild av cachade objekt och transienter, i stället för att varje server bygger sin egen isolerade cache.
Den sista punkten förbises ofta. Team lägger till en andra eller tredje webbnod men låter cachning och filhantering förbli lokala. Resultatet är ett inkonsekvent beteende som bara syns under belastning. En besökare får en färsk post i objektcachen. En annan hamnar på en annan nod och hittar den inte. En redaktör laddar upp en fil och en server ser den före de andra. WordPress kan fungera i det läget, men det fungerar inte förutsägbart.
Vad varje lager faktiskt gör
Den omvända proxyn gör mer än att fördela trafik med round-robin. I en seriös uppsättning hanterar den hälsokontroller, bevarar korrekta vidarebefordringshuvuden, terminerar TLS om det passar din design och tar bort noder med problem innan användarna märker det. Nginx, HAProxy och hanterade lastbalanserare i molnet klarar alla detta. Rätt val beror mindre på funktionslistor och mer på vem som ska underhålla det klockan två på natten.
Applikationsnoderna kräver disciplin. De ska inte lagra något affärskritiskt på lokal disk eller vara beroende av beständigt tillstånd på noden, om du inte medvetet har valt den kompromissen. Om det krävs manuell filsynkronisering eller särskild städning för att ersätta en nod som har fallerat, arbetar arkitekturen redan emot dig.
Lagringen är där förhastade implementeringar oftast går sönder. WordPress förväntar sig en konsekvent bild av wp-content/uploads, och vissa plugins förutsätter fortfarande åtkomst till det lokala filsystemet. Du kan lösa det med delad nätverkslagring eller genom att flytta media till objektlagring och anpassa stacken efter det. Inget av alternativen är gratis. Nätverksfilsystem kan ge latens och låsningsproblem. Avlastning av media minskar den risken, men du måste testa pluginkompatibiliteten och de redaktionella arbetsflödena.
Samma mönster dyker upp på större delade plattformar, särskilt i WordPress Multisite-arkitekturer. När flera webbplatser, redaktörer och plugins är beroende av samma plattform blir inkonsekvent filtillstånd och cache som glider isär mellan noderna snabbt supportärenden.
En sund, lastbalanserad WordPress-stack handlar mindre om att lägga till servrar och mer om att ta bort lokala antaganden. Det är den arkitekturförändringen som spelar roll.
Så väljer du arkitektur för lastbalansering
Det finns ingen enskild ”bästa” arkitektur för lastbalansering i WordPress. Det finns flera giltiga mönster, och vart och ett väger kontroll, kostnad och underhållsinsats på olika sätt.
Fel val kommer oftast av att man optimerar för en enda variabel. Team väljer den billigaste uppsättningen och ärver en tung driftbörda. Eller så väljer de det mest hanterade alternativet och upptäcker senare att de inte kan finjustera routning eller observerbarhet som de behöver. Rätt design beror på vem som ska driva den efter lanseringen, inte bara på vem som kan bygga den.
De tre vanliga mönstren
De flesta WordPress-stackar för företag hamnar i någon av dessa kategorier:
| Arkitektur | Passar bäst för | Komplexitet | Kostnad | Kontroll |
|---|---|---|---|---|
| Hanterad lastbalanserare i molnet | Team som vill ha hanterad infrastruktur och enklare skalning | Måttlig | Måttlig till hög | Måttlig |
| Egendriven proxy med Nginx eller HAProxy | Team med stark DevOps-kompetens och egna behov av routning | Hög | Varierar | Hög |
| CDN-baserad trafikfördelning | Innehållstunga webbplatser som kan flytta det mesta av trafiken ut till kanten | Lägre vid origin, men begränsad för full lastbalansering av applikationen | Varierar | Lägre över originets beteende |
Hanterade lastbalanserare i molnet
Hanterade lastbalanserare i molnet är oftast det säkraste standardvalet för företagsteam. De ger dig hälsokontroller, TLS-hantering, backendgrupper och integration med automatisk skalning utan att ditt team behöver vakta ännu en kritisk tjänst.
De är särskilt användbara när din infrastruktur redan bygger på hanterade tjänster i databas- och lagringslagret. Fördelen är lägre driftbörda. Nackdelen är mindre detaljerad finjustering, särskilt om du behöver mycket specifik routningslogik, anpassad buffring eller ovanlig hantering av huvuden.
Egendrivna proxyer
Nginx och HAProxy ger dig djup kontroll. Om du behöver egna upstream-regler, avancerad failover eller ett specifikt samspel mellan omskrivningar och cachning, ger ett egendrivet proxylager dina ingenjörer utrymme att forma plattformen precis som de vill.
Den kontrollen kommer med ansvar:
- Du äger uppdateringarna: Proxyn är ännu en produktionstjänst som måste uppdateras och säkras.
- Du äger observerbarheten: Loggar, mätvärden, larm och felsökning av upstreams blir ditt problem.
- Du äger motståndskraften: Om proxylagret är underdimensionerat blir det en enskild felpunkt.
För team som redan driver containerplattformar eller egen WordPress-hosting kan det här vara rätt väg. För team utan dedikerat infrastrukturstöd blir det ofta en dyr distraktion.
CDN-baserade angreppssätt
Ett CDN kan ta emot enorma mängder statisk och cachebar trafik, vilket innebär att betydligt färre förfrågningar når ditt origin. Det är värdefullt, men det är inte samma sak som full lastbalansering av applikationen.
Ett CDN är som starkast när din webbplats är innehållstung, har en global publik och kan cachas aggressivt. Det är svagare när förfrågningarna är dynamiska, personaliserade eller nära knutna till inloggade sessioner. Om din trafik till största delen kommer från inloggade WooCommerce-kunder eller medlemmar hjälper ett CDN, men det ersätter inte en bra arkitektur vid origin.
Välj den arkitektur som ditt team kan driva en helt vanlig tisdag, inte bara under lanseringsveckan.
Hantering av sessioner och databastillstånd
Tillståndshantering är den felpunkt jag oftast ser i projekt med lastbalansering för WordPress.
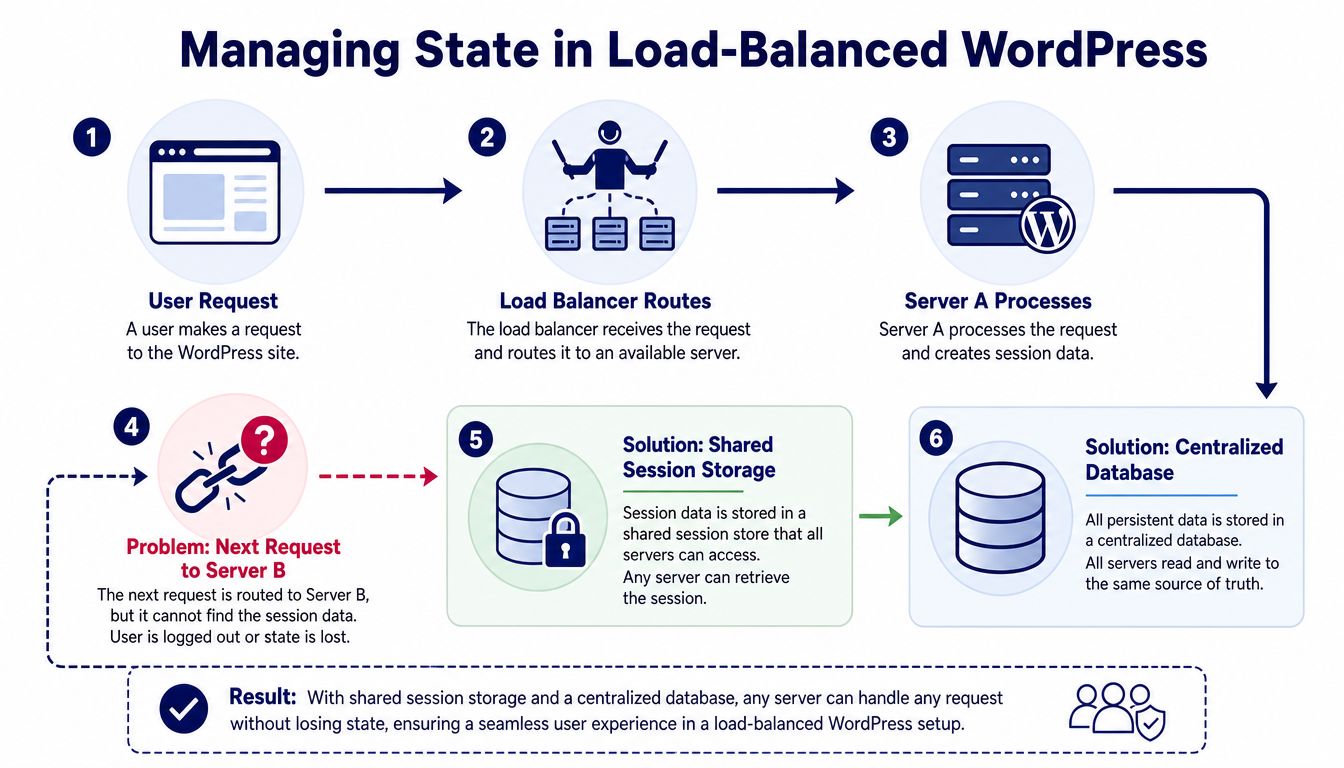
En WordPress-installation på en enda server klarar sig med antaganden som slutar fungera så fort du lägger till en andra applikationsnod. Förfrågningar studsar mellan servrar. En nod har en användares sessionsdata i minnet, en annan har det inte. En nod ser ett nyligen cachat objekt, en annan levererar inaktuella data. Om uppladdningar, cacheposter eller sessionsliknande data ligger på lokal disk eller i lokalt minne slutar plattformen bete sig som en enda applikation.
Därför är lastbalansering ofta ett dåligt första steg för mindre WordPress-webbplatser. Att lägga till fler webbnoder innan du har fixat cachestrategin, databaseffektiviteten och fillagringen ger oftast mer latens och driftrisk utan att lösa huvudflaskhalsen.
Varför sticky sessions är en tillfällig kompromiss
Sticky sessions kan minska fel som användarna märker genom att skicka samma besökare till samma backendnod. Det kan hjälpa för inloggad trafik, varukorgar, medlemsflöden och äldre plugins som förutsätter lokalt sessionstillstånd.
Det är ändå en kompromiss, inte en ren design.
Nackdelarna är förutsägbara:
- Failover blir svagare: Om den tilldelade noden fallerar kan användaren förlora varukorgens tillstånd, sessionens kontinuitet eller pågående åtgärder.
- Trafikfördelningen blir ojämn: Aktiva användare låses till specifika noder, vilket skapar heta punkter.
- Felsökningen blir svårare: Sporadiska problem blir nodspecifika och svårare att återskapa.
- Skalningen blir mindre effektiv: Fler servrar hjälper inte mycket om en stor del av trafiken fortfarande sitter fast på några få noder.
Jag använder bara sticky sessions när applikationen inte kan göras tillståndslös på kort sikt. Det är användbart under en migrering. Det är inte sluttillståndet.
Så ser en renare arkitektur ut
För WordPress som behöver verklig horisontell skalning är det bättre mönstret enkelt. Håll webbnoderna tillståndslösa. Lägg beständiga data i delade system som är byggda för det.
I praktiken innebär det oftast:
- En primär databas för skrivningar, så att inlägg, beställningar, ändrade inställningar och administrativa åtgärder har en enda sanningskälla.
- Läsrepliker där de hjälper, för lästunga arbetsbelastningar som tål replikeringsfördröjning.
- En delad objektcache som Redis, så att transient- och objektcachedata är tillgängliga på alla applikationsnoder.
- Delad medielagring, så att uppladdningar inte är knutna till en enda server.
WP Farm säger samma sak ur ett hostingperspektiv. Delad cachning och en tydlig databastopologi minskar frestelsen att behandla wp-content som ett tillståndslager, vilket oftast ger mer I/O-tryck och fler felsätt än team räknar med (WP Farm om lastbalansering i WordPress-hosting).
Läsrepliker förtjänar en varning. De hjälper på innehållstunga webbplatser med mycket läsning, men de kan skada arbetsbelastningar för e-handel och medlemskap om replikans fördröjning ger inaktuella läsningar efter skrivningar. En kund uppdaterar sin adress eller lägger en beställning, och nästa förfrågan läser från en replika som ligger efter och visar gamla data. Det är inget teoretiskt specialfall. Det är en vanlig källa till konstiga WooCommerce-buggar.
För butiker bör databasarbetet göras före eller parallellt med utrullningen av lastbalanseringen. Optimering av WooCommerce-databasen ger oftast mer mätbara förbättringar än att lägga till fler PHP-noder ovanpå ett ineffektivt frågemönster.
Ett praktiskt test hjälper här. Om det skulle förstöra inloggningar, varukorgar, uppladdningar eller administrativa arbetsflöden att stänga av en applikationsserver, är plattformen ännu inte redo för verklig lastbalansering.
En snabb illustration gör flödet tydligare:
Om en webbnod fortfarande bär sitt eget sessions- eller applikationstillstånd har du flera servrar, men inte en ordentligt distribuerad WordPress-applikation.
Praktisk implementering och konfiguration
Lastbalansering reparerar inte en svag WordPress-installation. Den lägger till ännu ett kontrollplan, ännu en felpunkt och mer driftarbete. På mindre webbplatser kan det extra lagret öka latensen och göra felsökningen svårare utan att lösa huvudflaskhalsen. När du implementerar det bör stacken redan vara så tillståndslös att det att lägga till eller ta bort en nod ändrar kapaciteten, inte beteendet.
Ett enkelt exempel på omvänd proxy med Nginx
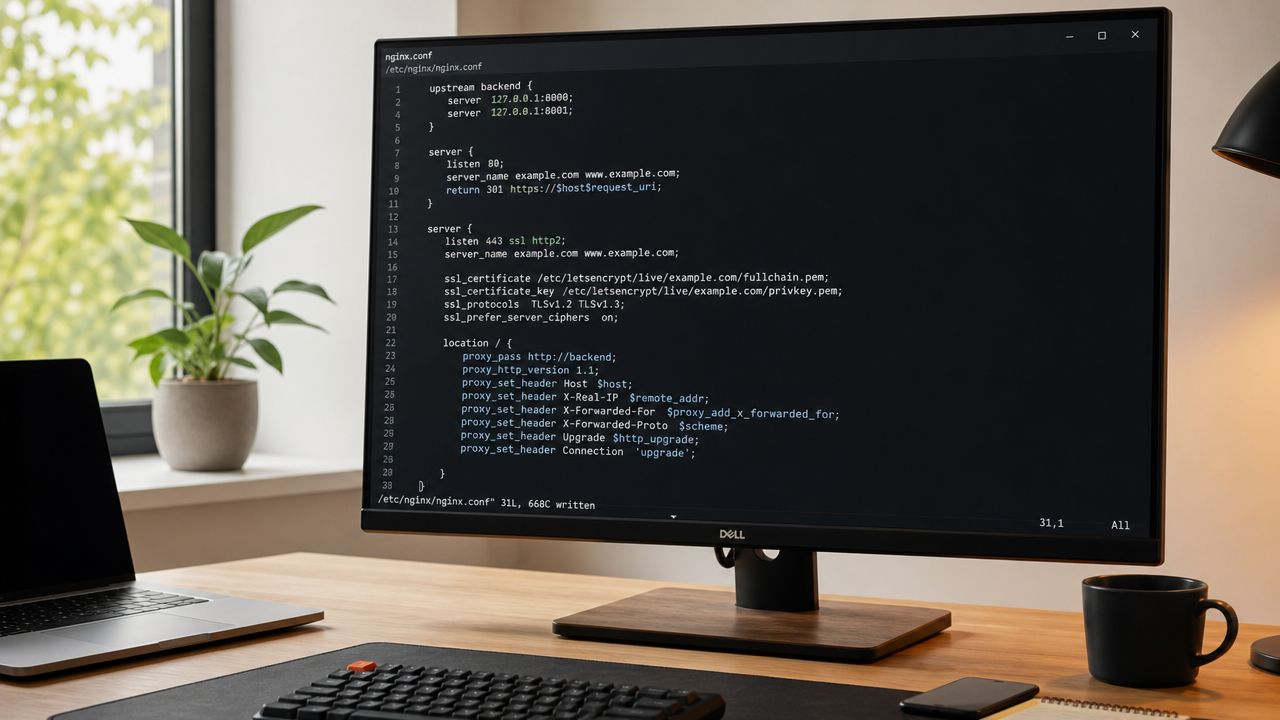
En omvänd proxy måste göra några få saker bra: hålla det publika värdnamnet stabilt, skicka vidare detaljerna i den ursprungliga förfrågan till upstream och fallera kontrollerat när en nod blir ohälsosam. Syntaxen nedan är medvetet enkel, men den speglar grundmönstret som många team använder innan de lägger till TLS-terminering, aktiva hälsokontroller och striktare regler för tidsgränser.
upstream wordpress_backend {
    server wordpress-app-1;
    server wordpress-app-2;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://wordpress_backend;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Det viktiga är inte själva kodsnutten. Proxyn måste bevara tillräckligt med kontext för att WordPress, PHP, loggar, säkerhetsverktyg och upstream-cacher ska kunna fatta rätt beslut. Om Host eller X-Forwarded-Proto är fel börjar WordPress generera felaktiga URL:er, omdirigeringar hamnar i loopar och problem med blandat innehåll dyker snabbt upp efter övergången.
WordPress-inställningar som team ofta missar
En WordPress-uppsättning med flera noder fallerar oftast på de tråkiga ställena.
Ställ in webbplatsens URL och hem-URL på den publika domänen bakom lastbalanseraren, inte på en enskild applikationsserver eller en rå IP-adress. I praktiken definierar många team också dessa värden i wp-config.php så att de inte kan glida isär i databasen under en förhastad migrering. Det är särskilt användbart när flera miljöer delar samma driftsättningsprocess.
Uppladdningar ska inte bara ligga på lokal disk. Använd objektlagring eller ett delat filsystem som du litar på driftmässigt. Objektlagring är oftast det renare alternativet eftersom det tar bort filsynkronisering och skillnader mellan noder, men det ger också beroenden till plugins och ändrar hur medie-URL:er, cachehuvuden och bildbehandling beter sig. Delade filsystem kan fungera, men under skrivtunga arbetsbelastningar blir de ofta den långsammaste och minst förutsägbara delen av stacken.
Cron kräver samma disciplin. Ställ in define('DISABLE_WP_CRON', true); och kör schemalagda uppgifter från en enda kontrollerad schemaläggare. Om varje webbnod kan utlösa cron utifrån verklig trafik blir dubblerade jobb och kapplöpningssituationer ett vanligt produktionsproblem i stället för ett specialfall.
En kompakt driftmodell ser ut så här:
| Område | Praktiskt val | Varför det hjälper |
|---|---|---|
| Uppladdningar | S3 eller motsvarande objektlagring | Håller media konsekvent mellan noder |
| Databas | Hanterad relationsdatabastjänst | Minskar administrationsbördan och förbättrar återställningsförmågan |
| Cache | Delad Redis-tjänst | Förhindrar fragmenterat objekttillstånd |
| Cron | Extern systemschemaläggare | Förhindrar dubblerad körning av jobb på flera noder |
Bygg det och förstör det före produktion
Det första riktiga testet är fel, inte sidhastighet. Ta en applikationsnod ur rotationen. Stoppa PHP-FPM på en annan. Rensa cachen mitt i ett redaktionellt publiceringsflöde. Kör en pluginuppdatering och bekräfta att administration, inloggningar, uppladdningar och asynkrona jobb fortfarande beter sig likadant. Om de här testerna är svåra att köra är arkitekturen fortfarande för skör.
En ordentlig WordPress-testmiljö (staging) för att testa ändringar i lastbalanseringen ger team en plats att öva på stegen i övergången, återställning, cacherensning och byte av noder utan att riskera intäkter eller publiceringsflöden.
Behandla driftsättning som konfigurationshantering, inte som handpåläggning på servrar. Baka in samma versioner av Nginx, PHP, WordPress och plugins i varje nod. Om en server behöver en manuell rättning för att stanna i rotationen håller klustret redan på att glida bort från specifikationen.
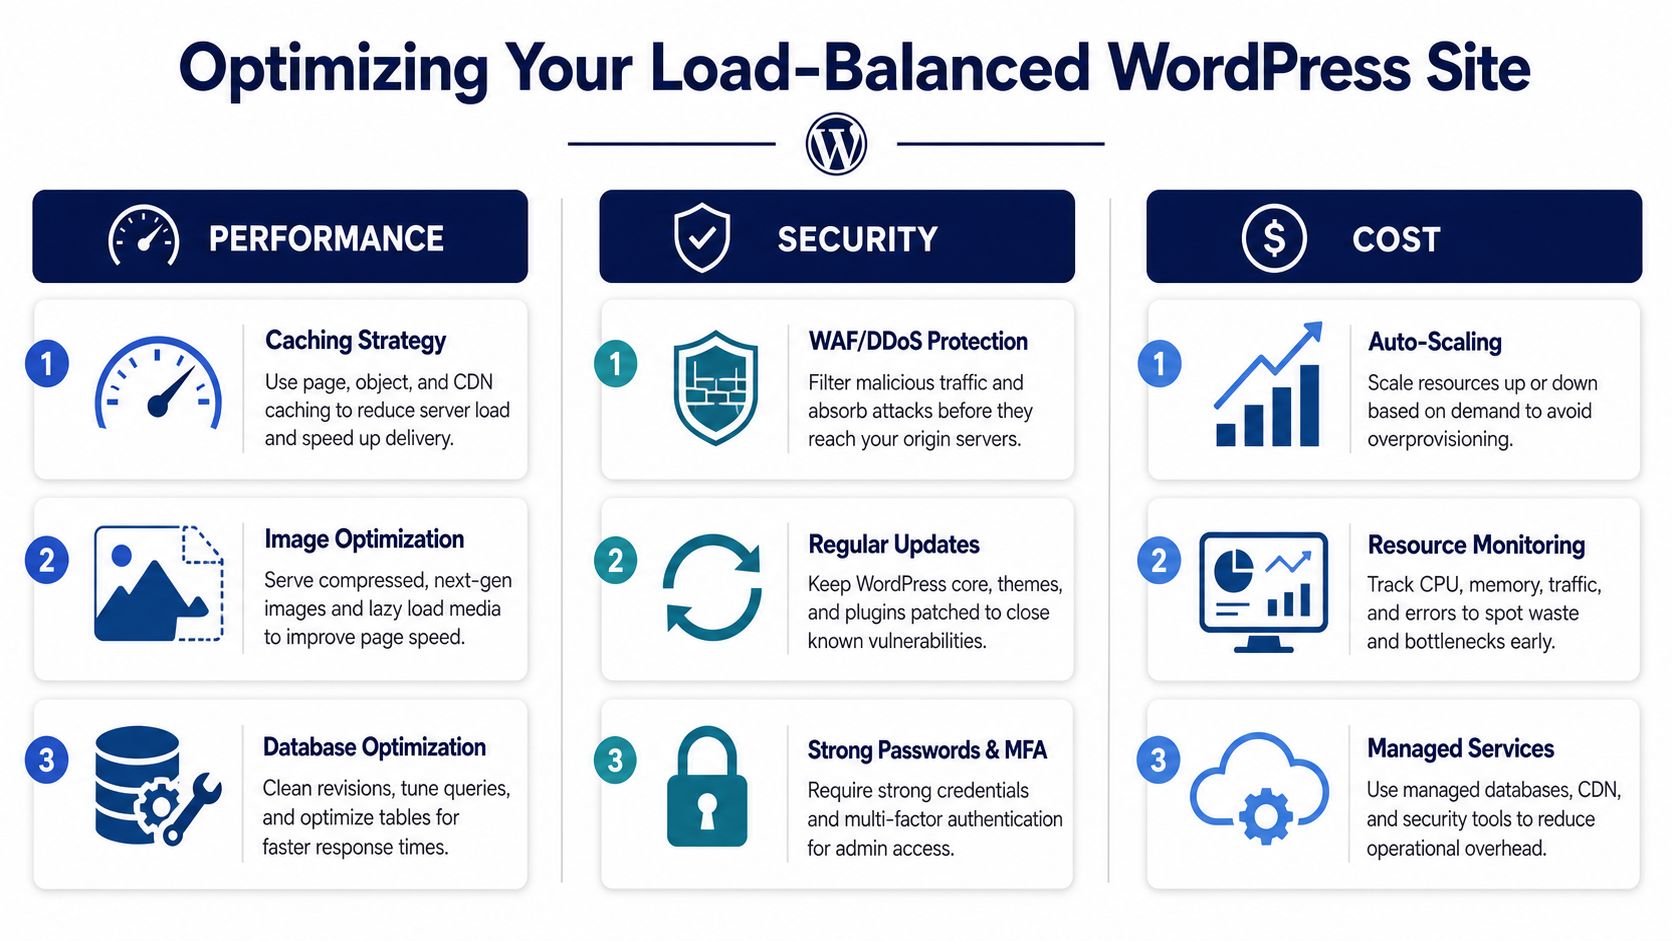
Optimera prestanda, säkerhet och kostnad
Lastbalansering gör inte en WordPress-stack effektiv av sig själv. På mindre eller dåligt inställda webbplatser kan den lägga till nätverkshopp, cachekomplexitet och driftkostnader innan den löser huvudflaskhalsen.
Prestandadisciplin
När ett kluster väl är i produktion beror prestandan oftast mindre på själva lastbalanseraren och mer på cachebeteendet, hur mycket marginal PHP-arbetarna har och mönstren i databasfrågorna. Därför definierar mogna team cacheregler explicit i stället för att behandla cachning som en plugininställning.
En rimlig standard är enkel. Cacha statiska resurser aggressivt. Använd kortare TTL för sidor som ändras ofta. Rensa cachen vid innehållsuppdateringar, produktändringar och viktiga redaktionella händelser. De exakta tiderna beror på applikationen, men driftprincipen är densamma: stabilt innehåll ska hållas borta från PHP och MySQL så länge som möjligt.
Övervakning kräver samma nivå av disciplin. Följ svarstid, CPU-mättnad, utmattning av PHP-arbetare, träffgrad i cachen och databaslatens tillsammans. Enbart drifttid döljer mycket smärta. En webbplats kan fortfarande vara tekniskt tillgänglig medan kassan blir långsammare, administrativa åtgärder fastnar eller inloggad trafik börjar köa bakom förfrågningar som inte finns i cachen.
Sätt larmtrösklar tillräckligt tidigt för att teamet ska kunna agera innan användarna märker något. I många WordPress-miljöer innebär det att larma vid ihållande resurstryck och ökande applikationslatens i stället för att vänta på ett fullständigt avbrott.
Säkerhetsläge
En lastbalanserad WordPress-uppsättning bör minska attackytan. Den publika ingångspunkten är lastbalanseraren och säkerhetslagret. Applikationsnoderna ska inte ta emot direkt trafik från internet, om det inte finns ett specifikt driftskäl och kompenserande kontroller.
Håll origin-instanserna privata där det går. Begränsa administrativ åtkomst. Terminera TLS på ett rent sätt. Om webbplatsen har en betydande exponering, placera en WAF framför lastbalanseraren och se till att åtkomstreglerna för origin bara litar på den vägen. Det här är ännu viktigare för WooCommerce, medlemsplattformar och redaktioner som arbetar i wp-admin från många platser.
En centraliserad ingångspunkt gör också incidenthanteringen renare. Loggar, begränsning av förfrågningar, IP-kontroller och filtrering av botar fungerar bättre när trafiken kommer in via en enda kontrollerad väg.
Kostnadskontroll
Team överdimensionerar ofta. Ett kluster med tre noder, hanterad databas, Redis, objektlagring, CDN, WAF och automatisk skalning kan vara rätt svar för en affärskritisk plattform. Det är också ett dyrt svar på ett problem som kanske hade kunnat lösas med helsidescache, bättre finjustering av frågor eller mer kapacitet på en enda nod.
Kostnadskontroll börjar med att anpassa arkitekturen till arbetsbelastningen. Om trafiken kommer i toppar men till största delen är anonym, investera först i cachning och avlastning via CDN. Om trafiken är jämnt hög och kommer från inloggade användare, lägg mer uppmärksamhet på PHP-samtidighet, objektcachens effektivitet och databaskapacitet. Om plattformen har strikta krav på tillgänglighet kan redundans motivera högre kostnader redan innan den genomsnittliga användningen ser hög ut.
En praktisk checklista för driften ser ut så här:
- Mät mättnad, inte bara drifttid: Ökande latens, fulla pooler av PHP-arbetare och låg träffgrad i cachen syns oftast före ett avbrott.
- Använd hanterade tjänster där de tar bort verkligt slit: Hanterade databas- och cachelager är ofta värda merkostnaden om teamet inte vill äga säkerhetskopiering, failover, uppdateringar och återställning.
- Var ärlig om arkitekturen: Om delad lagring, kommunikation mellan noder eller cachemissar driver upp latensen ökar fler applikationsnoder oftast kostnaden snabbare än prestandan.
- Se regelbundet över hur den automatiska skalningen beter sig: Dåliga tröskelvärden kan skala för sent under trafiktoppar eller för ofta eftersom applikationen är ineffektiv.
De bästa lastbalanserade WordPress-plattformarna är inte de största. Det är de där varje tillagt lager har en tydlig uppgift, en mätbar vinst och en driftkostnad som teamet förstår.
Din migreringsväg till en skalbar arkitektur
Behandla migreringen som ett ingenjörsprojekt i etapper, inte som ett byte av hosting.
Börja med att mäta prestandan på den nuvarande plattformen så att du vet om det underliggande problemet är CPU, PHP-arbetare, konkurrens om databasen, cachemissar eller fil-I/O. Bygg sedan målmiljön i staging och validera de svåra delarna först: inloggningsbeteende, mediekonsistens, administrativa arbetsflöden, schemalagda uppgifter och invalidering av cachen.
Kör därefter kontrollerade tester mot den nya stacken och öva på fel. Ta en nod ur rotationen. Bekräfta att webbplatsen fortfarande fungerar som den ska. Testa publicering av innehåll och eventuella kass- eller medlemsflöden under realistiska förhållanden. Först då bör du planera övergången.
De renaste migreringarna använder en stegvis lansering med tät övervakning direkt efter att trafiken har flyttats. Det ger teamet utrymme att upptäcka problem med tillstånd, cache eller routning innan de blir affärsincidenter.
Lastbalansering för WordPress är värt det när plattformen har vuxit ur en enda nod. Det är ett misstag när det används som ersättning för grundläggande prestandaarbete. Skillnaden ligger i arkitekturdisciplinen.
Om ditt team planerar övergången till klustrad WordPress, WooCommerce med mycket trafik eller en mer motståndskraftig företagsstack kan IMADO hjälpa dig att utforma arkitekturen, validera migreringsvägen och bygga en plattform som dina redaktörer och ingenjörer kan driva.