Die meisten Ratschläge zur Skalierung von WordPress springen direkt zum Load Balancer. Das ist oft der falsche Schritt.
Ein Load Balancer löst eine bestimmte Klasse von Problemen. Er hilft, wenn ein einzelner Applikationsserver den Traffic nicht zuverlässig aufnehmen kann, wenn Sie Redundanz brauchen oder wenn eine einzelne Maschine zum operativen Risiko geworden ist. Bei vielen Websites bringt ein zu früh eingeführter Load Balancer jedoch mehr bewegliche Teile, mehr Fehlerszenarien und mehr Latenz als Nutzen.
Die bessere Frage lautet nicht „Wie führen wir WordPress Load Balancing ein?”, sondern „Welchen Engpass wollen wir beseitigen?”. Bei kleineren Projekten lösen starkes Page Caching, Object Caching, Datenbankbereinigung, das Auslagern von Bildern und eine disziplinierte Plugin-Auswahl das Problem meist schneller und mit weniger Komplexität. Bei Enterprise-WordPress gibt es jedoch einen Punkt, an dem horizontale Verteilung zwingend wird. Ab dann zählt die Architektur mehr als einzelnes Tuning.
Wann Sie WordPress Load Balancing wirklich brauchen
Die verbreitete Annahme ist einfach: Mehr Server bedeuten bessere Performance. In der Praxis funktioniert das so nicht.
Bei WordPress-Websites mit wenig Traffic kann Load Balancing die Performance sogar verschlechtern. SpinupWP stellt fest, dass Single-Server-Setups Konfigurationen mit Load Balancer bis etwa 8 gleichzeitige Nutzer übertreffen und dass der zusätzliche Netzwerk-Hop Anfragen verlangsamen kann, wenn die CPU-Auslastung unter 20 % liegt (Analyse von SpinupWP zu Load Balancern). Genau diese Nuance überspringen die meisten allgemeinen Leitfäden.
Wann ein Load Balancer verfrüht ist
Wenn Ihre Website überwiegend aus cachebaren Inhalten besteht, setzen Sie woanders an. Ein einzelner gut abgestimmter Server mit Full-Page-Caching, Redis Object Caching, CDN und disziplinierter Plugin-Nutzung schlägt in der Regel einen verteilten Stack, der nicht auf Zustand, Storage und Cache-Kohärenz ausgelegt wurde.
Sie brauchen WordPress Load Balancing wahrscheinlich noch nicht, wenn Ihre aktuellen Probleme so aussehen:
- Cache-Misses durch fehlerhaftes Plugin-Verhalten: Ein Plugin umgeht den Page Cache und lässt den gesamten Stack langsam wirken.
- Aufgeblähte Medien und langsame Auslieferung von Assets: Große Uploads und nicht optimierte Bilder sättigen I/O oder Bandbreite.
- Datenbank-Drift: Autoloaded Options, abgelaufene Transients und unnötige Abfragen schieben vermeidbare Arbeit in jede Anfrage.
- Operative Einfachheit ist wichtiger: Ihr Team braucht Zuverlässigkeit und schnelle Rollbacks, keine größere Angriffs- und Betriebsfläche.
Für Teams, die entscheiden müssen, ob sie zuerst in Skalierungsarchitektur oder in grundlegende Performance-Arbeit investieren, lohnt sich an diesem Punkt meist ein Review durch erfahrene Engineers. Enterprise-WordPress-Lösungen wirken am besten, wenn sie beim tatsächlichen Engpass ansetzen und nicht beim angesagtesten Muster.
Praxisregel: Wenn Caching und Datenbankhygiene nicht sauber umgesetzt sind, verdeckt ein Load Balancer das Problem meist, statt es zu beheben.
Wann er notwendig wird
Load Balancing ergibt Sinn, wenn Verfügbarkeit und Parallelität wichtiger sind als architektonische Einfachheit. Denken Sie an Produktlaunches, große WooCommerce-Kampagnen, Mitgliederplattformen mit viel angemeldetem Traffic, Publisher-Websites mit Traffic-Spitzen oder Unternehmenswebsites, die sich den Ausfall eines einzelnen Knotens nicht leisten können.
In diesen Fällen geht es nicht nur um Geschwindigkeit. Es geht um Resilienz. Ein Knoten muss ausfallen können, ohne die ganze Plattform mitzureißen. Sie brauchen Health Checks, vorhersehbares Routing und eine Infrastruktur, die Lastspitzen abfängt, ohne Notfalländerungen unter Druck zu erzwingen.
Dann ist WordPress Load Balancing keine Option mehr, sondern Infrastruktur.
Die Architektur von Load Balancing verstehen
Ein produktionsreifes WordPress-Setup mit Load Balancing hat vier bewegliche Teile: einen Load Balancer davor, mehrere zustandslose Applikationsknoten dahinter, gemeinsamen Zugriff auf Uploads und eine zentrale Cache-Schicht, die jeder Knoten nutzen kann.
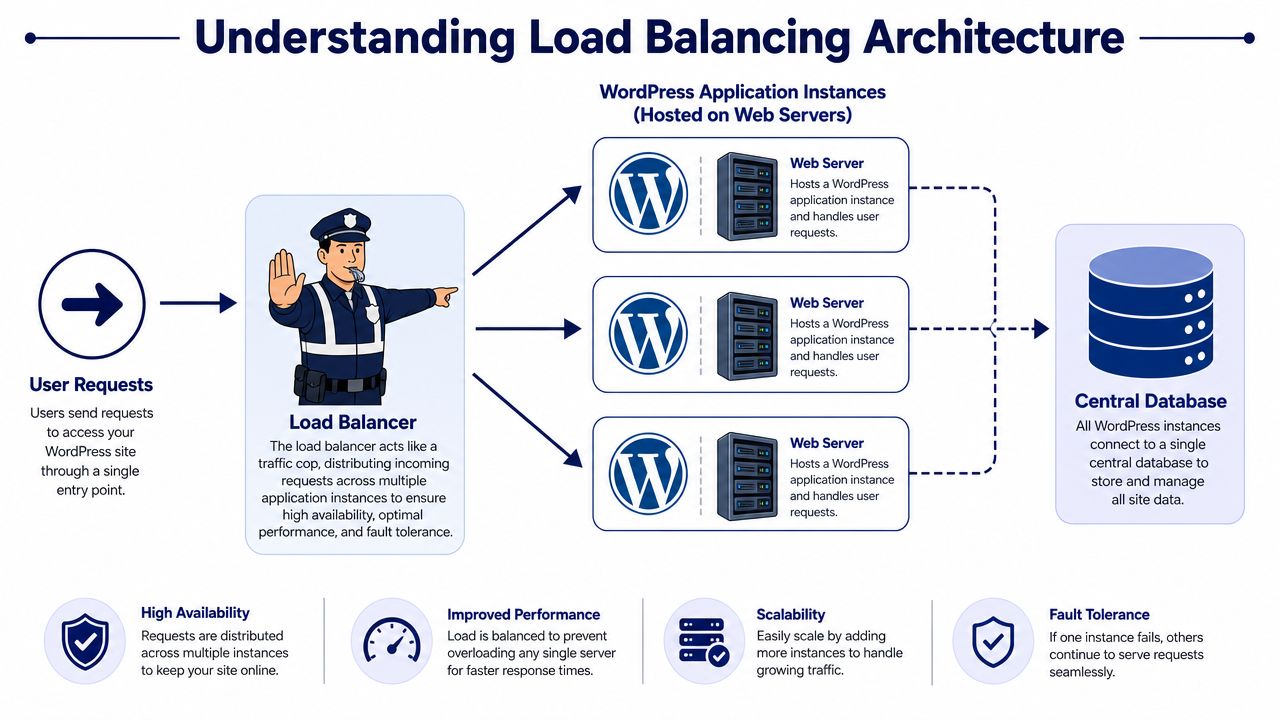
Das klingt einfach, aber genau hier werden kleinere WordPress-Installationen langsamer, fragiler und teurer. Die Architektur hilft nur, wenn jede Schicht einen echten Engpass löst. Wenn der Traffic weiterhin überwiegend cachebar ist und ein einzelner optimierter Knoten ihn bewältigt, erzeugt verteilte Infrastruktur zusätzliche Netzwerk-Hops, mehr Fehlerquellen und mehr Betriebsaufwand ohne nennenswerten Gewinn.
Die vier Teile, auf die es ankommt
Jede Komponente hat eine klare Aufgabe:
- Der Load Balancer oder Reverse Proxy nimmt eingehenden Traffic an, prüft den Zustand der Backends und schickt Anfragen an einen Knoten, der sie bedienen kann.
- WordPress-Applikationsknoten führen PHP aus, verarbeiten ungecachte Anfragen und sollten als austauschbare Worker behandelt werden, nicht als langlebige „Haustiere”.
- Gemeinsamer Storage oder Media Offload macht Uploads für jeden Knoten verfügbar, sodass Dateien nicht von der lokalen Festplatte abhängen.
- Ein zentraler Object Cache gibt allen Knoten dieselbe Sicht auf gecachte Objekte und Transients, statt jeden Server einen eigenen, isolierten Cache aufbauen zu lassen.
Der letzte Punkt wird oft übersehen. Teams fügen einen zweiten oder dritten Webknoten hinzu, lassen Cache und Dateihandling aber lokal. Das Ergebnis ist inkonsistentes Verhalten, das nur unter Last auftritt. Ein Besucher bekommt einen frischen Eintrag im Object Cache. Ein anderer landet auf einem anderen Knoten und verfehlt ihn. Eine Redakteurin lädt eine Datei hoch, und ein Server sieht sie vor den anderen. WordPress kann in diesem Zustand laufen, aber nicht vorhersehbar.
Was jede Schicht wirklich tut
Der Reverse Proxy macht mehr als Round-Robin-Verteilung. In einem ernsthaften Setup übernimmt er Health Checks, erhält die richtigen Forwarding-Header, terminiert TLS, wenn das zum Design passt, und nimmt fehlerhafte Knoten aus der Rotation, bevor Nutzer es bemerken. Nginx, HAProxy und verwaltete Cloud-Load-Balancer können das alle. Die richtige Wahl hängt weniger von Funktionslisten ab als davon, wer das System um 2 Uhr nachts betreut.
Applikationsknoten brauchen Disziplin. Sie sollten nichts Geschäftskritisches auf der lokalen Festplatte halten und nicht von Sticky State abhängen, es sei denn, Sie haben diesen Kompromiss bewusst gewählt. Wenn der Austausch eines ausgefallenen Knotens manuellen Datei-Sync oder besondere Aufräumarbeiten erfordert, arbeitet die Architektur bereits gegen Sie.
Beim Storage scheitern überhastete Implementierungen meist. WordPress erwartet eine konsistente Sicht auf wp-content/uploads, und manche Plugins setzen weiterhin Zugriff auf das lokale Dateisystem voraus. Sie können das mit gemeinsamem Netzwerk-Storage lösen oder indem Sie Medien in Object Storage auslagern und den Stack darauf abstimmen. Keine der beiden Optionen ist kostenlos. Netzwerk-Dateisysteme können Latenz und Locking-Probleme mitbringen. Media Offload senkt dieses Risiko, aber Plugin-Kompatibilität und redaktionelle Workflows müssen getestet werden.
Dasselbe Muster zeigt sich auf größeren gemeinsam genutzten Plattformen, besonders in WordPress-Multisite-Architekturen. Sobald mehrere Websites, Redaktionen und Plugins von derselben Plattform abhängen, werden inkonsistente Dateizustände und auseinanderlaufende Caches pro Knoten schnell zu Support-Vorfällen.
Bei einem gesunden WordPress-Stack mit Load Balancing geht es weniger darum, Server hinzuzufügen, als darum, lokale Annahmen zu entfernen. Das ist der architektonische Wandel, der zählt.
Die passende Load-Balancing-Architektur wählen
Es gibt nicht die eine „beste” Architektur für WordPress Load Balancing. Es gibt mehrere gültige Muster, und jedes gewichtet Kontrolle, Kosten und Wartungsaufwand anders.
Die falsche Wahl entsteht meist, wenn nur eine Variable optimiert wird. Teams wählen das günstigste Setup und erben hohen Betriebsaufwand. Oder sie wählen die am stärksten verwaltete Option und stellen später fest, dass sie Routing oder Observability nicht wie benötigt anpassen können. Das richtige Design hängt davon ab, wer es nach dem Launch betreibt, nicht nur davon, wer es bauen kann.
Die drei gängigen Muster
Die meisten Enterprise-WordPress-Stacks landen in einer dieser Kategorien:
| Architektur | Am besten für | Komplexität | Kosten | Kontrolle |
|---|---|---|---|---|
| Verwalteter Cloud-Load-Balancer | Teams, die verwaltete Infrastruktur und einfachere Skalierung wollen | Mittel | Mittel bis hoch | Mittel |
| Selbst gehosteter Proxy mit Nginx oder HAProxy | Teams mit starken DevOps-Fähigkeiten und individuellen Routing-Anforderungen | Hoch | Variabel | Hoch |
| CDN-basierte Traffic-Verteilung | Content-lastige Websites, die den Großteil des Traffics an die Edge verlagern können | Geringer am Origin, aber begrenzt für vollständiges Application Load Balancing | Variabel | Geringer beim Origin-Verhalten |
Verwaltete Cloud-Load-Balancer
Verwaltete Cloud-Load-Balancer sind für Enterprise-Teams meist die sicherste Standardwahl. Sie bieten Health Checks, TLS-Handling, Backend-Pools und Integration mit Auto-Scaling, ohne dass Ihr Team einen weiteren kritischen Dienst betreuen muss.
Besonders nützlich sind sie, wenn Ihre Infrastruktur bereits auf verwaltete Dienste für Datenbank und Storage setzt. Der Vorteil ist geringerer Betriebsaufwand. Der Nachteil ist weniger feines Tuning, vor allem wenn Sie sehr spezifische Routing-Logik, eigenes Buffering-Verhalten oder ungewöhnliches Header-Handling brauchen.
Selbst gehostete Proxys
Nginx und HAProxy geben Ihnen tiefgehende Kontrolle. Wenn Sie eigene Upstream-Regeln, fortgeschrittenes Failover-Verhalten oder ein bestimmtes Zusammenspiel von Rewrites und Cache brauchen, bietet eine selbst gehostete Proxy-Schicht Ihren Engineers Raum, die Plattform genau so zu gestalten, wie sie es wollen.
Diese Kontrolle bringt Verantwortung mit sich:
- Sie verantworten das Patching: Der Proxy ist ein weiterer Produktionsdienst, der aktualisiert und abgesichert werden muss.
- Sie verantworten die Observability: Logs, Metriken, Alerts und Upstream-Debugging werden zu Ihrem Problem.
- Sie verantworten die Resilienz: Wenn die Proxy-Schicht unterdimensioniert ist, wird sie zum Single Point of Failure.
Für Teams, die bereits Container-Plattformen oder eigenes WordPress-Hosting betreiben, kann das der richtige Weg sein. Für Teams ohne dedizierte Infrastrukturunterstützung wird es oft zu einer teuren Ablenkung.
CDN-basierte Ansätze
Ein CDN kann enorme Mengen an statischem und cachebarem Traffic abfangen, sodass deutlich weniger Anfragen überhaupt Ihren Origin erreichen. Das ist wertvoll, aber nicht dasselbe wie vollständiges Application Load Balancing.
Ein CDN ist am stärksten, wenn Ihre Website content-lastig, global verteilt und aggressiv cachebar ist. Schwächer ist es, wenn Anfragen dynamisch, personalisiert oder eng an angemeldete Sessions gebunden sind. Wenn Ihr Traffic überwiegend aus angemeldeten WooCommerce-Kunden oder Mitgliedern besteht, hilft ein CDN, ersetzt aber keine gute Origin-Architektur.
Wählen Sie die Architektur, die Ihr Team an einem ganz normalen Dienstag betreiben kann, nicht nur in einer Launch-Woche.
Sessions und Datenbankzustand handhaben
Zustandsverwaltung ist der Fehlerpunkt, den ich in WordPress-Load-Balancing-Projekten am häufigsten sehe.
Ein WordPress-Build auf einem einzelnen Server kommt mit Annahmen durch, die nicht mehr funktionieren, sobald Sie einen zweiten Applikationsknoten hinzufügen. Anfragen springen zwischen Servern hin und her. Ein Knoten hat die Session-Daten eines Nutzers im Speicher, ein anderer nicht. Ein Knoten sieht ein kürzlich gecachtes Objekt, ein anderer liefert veraltete Daten aus. Wenn Uploads, Cache-Einträge oder session-ähnliche Daten auf der lokalen Festplatte oder im lokalen Speicher liegen, verhält sich die Plattform nicht mehr wie eine einzige Anwendung.
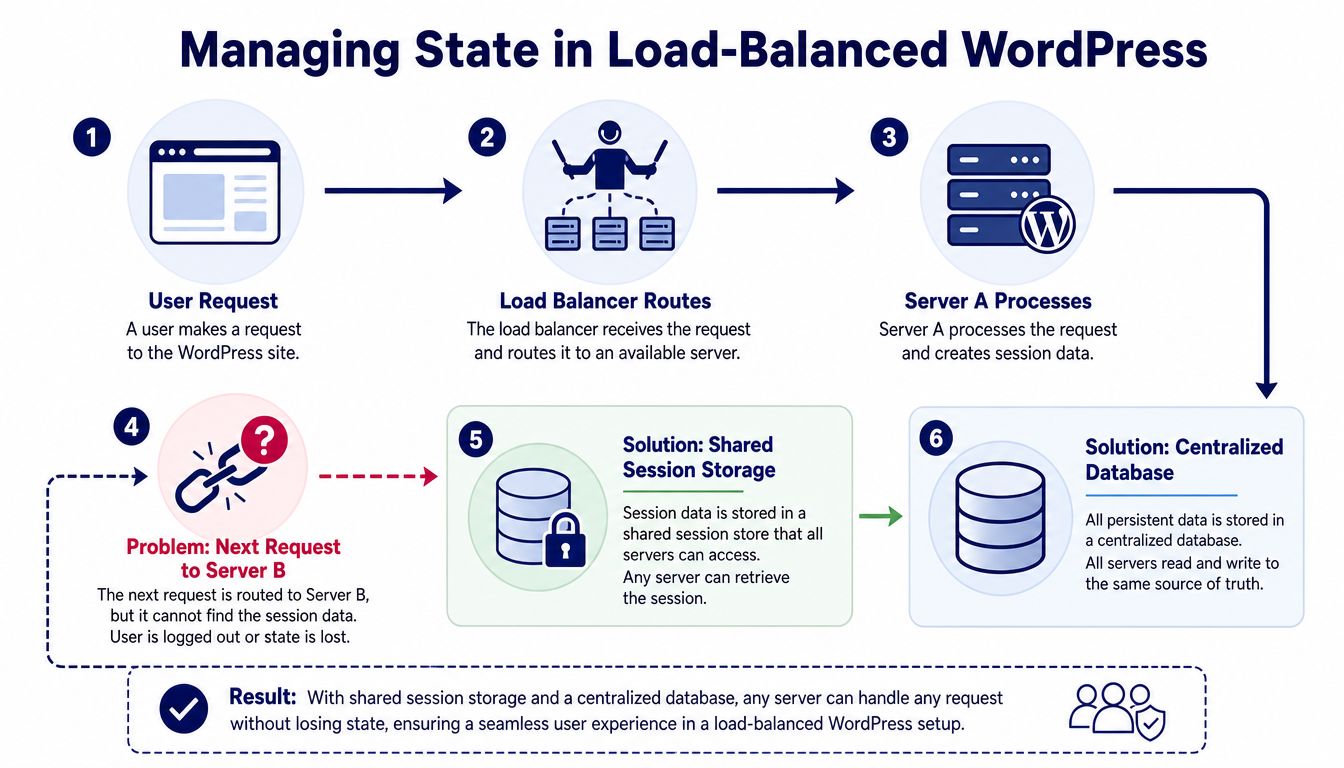
Das ist auch der Grund, warum Load Balancing für kleinere WordPress-Websites oft der falsche erste Schritt ist. Wer weitere Webknoten hinzufügt, bevor Cache-Strategie, Datenbankeffizienz und Dateispeicherung in Ordnung sind, erhöht meist Latenz und Betriebsrisiko, ohne den eigentlichen Engpass zu lösen.
Warum Sticky Sessions ein vorübergehender Kompromiss sind
Sticky Sessions können für Nutzer sichtbare Fehler reduzieren, indem sie denselben Besucher immer wieder an denselben Backend-Knoten schicken. Das kann bei angemeldetem Traffic, Warenkörben, Mitgliederprozessen und älteren Plugins helfen, die lokalen Session-Zustand voraussetzen.
Es bleibt trotzdem ein Kompromiss und kein sauberes Design.
Die Nachteile sind vorhersehbar:
- Failover wird schwächer: Fällt der zugewiesene Knoten aus, verliert der Nutzer möglicherweise den Warenkorb, die Anmeldung oder laufende Aktionen.
- Die Traffic-Verteilung wird ungleichmäßig: Aktive Nutzer bleiben an bestimmte Knoten gebunden, wodurch Hotspots entstehen.
- Die Fehlersuche wird schwieriger: Sporadische Probleme werden knotenspezifisch und schwerer zu reproduzieren.
- Die Skalierung wird ineffizienter: Zusätzliche Server helfen wenig, wenn ein großer Teil des Traffics weiterhin an wenigen Knoten klebt.
Ich setze Sticky Sessions nur ein, wenn sich die Anwendung kurzfristig nicht zustandslos machen lässt. Während einer Migration sind sie nützlich. Der Endzustand sind sie nicht.
Wie eine sauberere Architektur aussieht
Für WordPress, das echte horizontale Skalierung braucht, ist das bessere Muster einfach. Halten Sie Webknoten zustandslos. Legen Sie persistente Daten in gemeinsame Systeme, die dafür gebaut sind.
In der Praxis bedeutet das meist:
- Eine primäre Datenbank für Schreibzugriffe, damit Beiträge, Bestellungen, Einstellungsänderungen und Admin-Aktionen eine einzige Quelle der Wahrheit haben.
- Read Replicas, wo sie helfen, für leselastige Workloads, die Replikationsverzögerung tolerieren.
- Ein gemeinsamer Object Cache wie Redis, damit Transients und Object-Cache-Daten jedem Applikationsknoten zur Verfügung stehen.
- Gemeinsamer Medienspeicher, damit Uploads nicht an einen Server gebunden sind.
WP Farm argumentiert aus Hosting-Sicht genauso. Ein gemeinsamer Cache und eine klare Datenbanktopologie verringern die Versuchung, wp-content als Zustandsschicht zu behandeln, was meist mehr I/O-Druck und mehr Fehlerszenarien erzeugt, als Teams erwarten (WP Farm zu Load Balancing im WordPress-Hosting).
Bei Read Replicas ist eine Warnung angebracht. Sie helfen bei content-lastigen Websites mit hohem Lesevolumen, können aber Commerce- und Mitglieder-Workloads schaden, wenn Replikationsverzögerung nach Schreibvorgängen zu veralteten Lesezugriffen führt. Ein Kunde aktualisiert seine Adresse oder gibt eine Bestellung auf, und die nächste Anfrage liest von einer verzögerten Replica und zeigt alte Daten. Das ist kein theoretischer Randfall. Es ist eine häufige Ursache seltsamer WooCommerce-Bugs.
Bei Shops sollte die Datenbankarbeit vor oder parallel zur Einführung von Load Balancing stattfinden. WooCommerce-Datenbankoptimierung bringt meist messbarere Gewinne, als zusätzliche PHP-Knoten auf ein ineffizientes Abfragemuster zu setzen.
Ein praktischer Test hilft hier. Wenn das Abschalten eines Applikationsservers Logins, Warenkörbe, Uploads oder Admin-Workflows kaputtmachen würde, ist die Plattform noch nicht bereit für echtes Load Balancing.
Eine kurze Visualisierung hilft, den Ablauf zu verdeutlichen:
Wenn ein Webknoten noch eigenen Session- oder Anwendungszustand trägt, haben Sie mehrere Server, aber keine sauber verteilte WordPress-Anwendung.
Praktische Umsetzung und Konfiguration
Load Balancing repariert keinen schwachen WordPress-Build. Es fügt eine weitere Steuerungsebene, eine weitere Fehlerquelle und mehr Betriebsaufwand hinzu. Bei kleineren Websites kann diese zusätzliche Schicht die Latenz erhöhen und die Fehlersuche erschweren, ohne den eigentlichen Engpass zu lösen. Bis Sie es einführen, sollte der Stack bereits so zustandslos sein, dass das Hinzufügen oder Entfernen eines Knotens die Kapazität ändert, nicht das Verhalten.
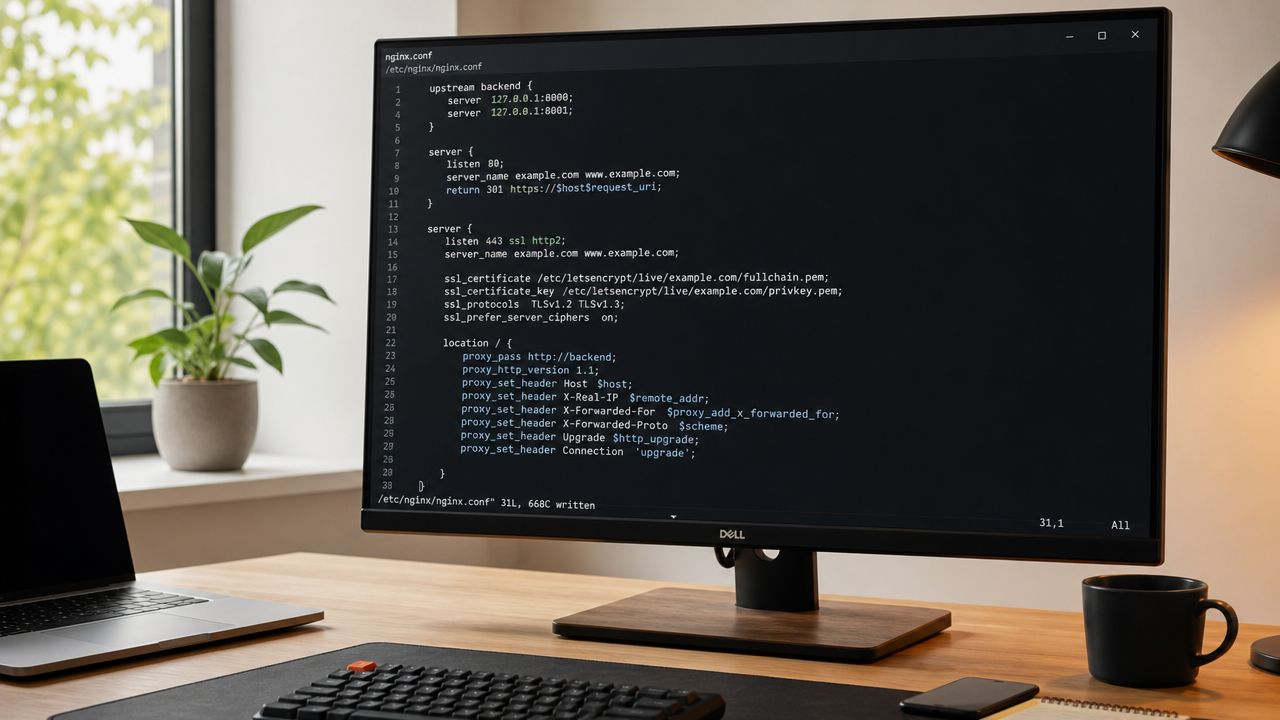
Ein einfaches Beispiel für einen Nginx Reverse Proxy
Ein Reverse Proxy sollte einige Dinge gut erledigen: den öffentlichen Hostnamen stabil halten, die ursprünglichen Anfragedetails an den Upstream weitergeben und sauber reagieren, wenn ein Knoten ausfällt. Die folgende Syntax ist bewusst einfach, bildet aber das Grundmuster ab, das viele Teams nutzen, bevor sie TLS-Terminierung, aktive Health Checks und strengere Timeout-Richtlinien ergänzen.
upstream wordpress_backend {
    server wordpress-app-1;
    server wordpress-app-2;
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://wordpress_backend;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
Entscheidend ist nicht das Snippet selbst. Der Proxy muss genug Kontext erhalten, damit WordPress, PHP, Logs, Sicherheitstools und Upstream-Caches richtige Entscheidungen treffen können. Sind Host oder X-Forwarded-Proto falsch, erzeugt WordPress fehlerhafte URLs, Weiterleitungen laufen in Schleifen, und Mixed-Content-Probleme tauchen nach der Umstellung schnell auf.
WordPress-spezifische Einstellungen, die Teams oft übersehen
Ein WordPress-Setup mit mehreren Knoten scheitert meist an den langweiligen Stellen.
Setzen Sie Website-URL und Home-URL auf die öffentliche Domain hinter dem Load Balancer, nicht auf einen einzelnen Applikationsserver oder eine nackte IP-Adresse. In der Praxis definieren viele Teams diese Werte zusätzlich in wp-config.php, damit sie bei einer überhasteten Migration nicht in der Datenbank abweichen können. Das ist besonders nützlich, wenn mehrere Umgebungen denselben Deployment-Prozess teilen.
Uploads sollten nicht nur auf der lokalen Festplatte liegen. Nutzen Sie Object Storage oder ein gemeinsames Dateisystem, dem Sie operativ vertrauen. Object Storage ist meist die sauberere Option, weil es Datei-Sync-Jobs und Abweichungen zwischen Knoten beseitigt, bringt aber auch Plugin-Abhängigkeiten mit und verändert das Verhalten von Medien-URLs, Cache-Headern und Bildverarbeitung. Gemeinsame Dateisysteme können funktionieren, werden bei schreibintensiven Workloads aber oft zum langsamsten und am wenigsten vorhersehbaren Teil des Stacks.
Cron braucht dieselbe Disziplin. Setzen Sie define('DISABLE_WP_CRON', true); und führen Sie geplante Jobs über einen einzigen kontrollierten Scheduler aus. Wenn jeder Webknoten Cron durch Live-Traffic auslösen kann, werden doppelte Jobs und Race Conditions zum alltäglichen Produktionsproblem statt zum Randfall.
Ein kompaktes Betriebsmodell sieht so aus:
| Bereich | Praktische Wahl | Warum es hilft |
|---|---|---|
| Uploads | S3 oder vergleichbarer Object Storage | Hält Medien über alle Knoten hinweg konsistent |
| Datenbank | Verwalteter relationaler Dienst | Senkt den Administrationsaufwand und verbessert die Wiederherstellbarkeit |
| Cache | Gemeinsamer Redis-Dienst | Verhindert fragmentierten Objektzustand |
| Cron | Externer System-Scheduler | Vermeidet doppelte Ausführung von Aufgaben auf mehreren Knoten |
Vor der Produktion aufbauen und kaputtmachen
Der erste echte Test ist der Ausfall, nicht die Seitengeschwindigkeit. Nehmen Sie einen Applikationsknoten aus der Rotation. Beenden Sie PHP-FPM auf einem anderen. Leeren Sie den Cache während eines redaktionellen Veröffentlichungsvorgangs. Führen Sie ein Plugin-Update durch und prüfen Sie, ob Admin-Bereich, Logins, Uploads und asynchrone Jobs sich weiterhin gleich verhalten. Wenn sich diese Tests nur schwer durchführen lassen, ist die Architektur noch zu fragil.
Eine richtige WordPress-Staging-Umgebung zum Testen von Load-Balancing-Änderungen gibt Teams einen Ort, um Umstellungsschritte, Rollback, Cache-Purge-Verhalten und den Austausch von Knoten zu proben, ohne Umsatz oder Veröffentlichungsprozesse zu gefährden.
Behandeln Sie Deployment als Konfigurationsmanagement, nicht als handoptimierte Serverarbeit. Backen Sie dieselben Versionen von Nginx, PHP, WordPress und Plugins in jeden Knoten ein. Wenn ein Server einen manuellen Fix braucht, um in der Rotation zu bleiben, weicht der Cluster bereits von der Spezifikation ab.
Performance, Sicherheit und Kosten optimieren
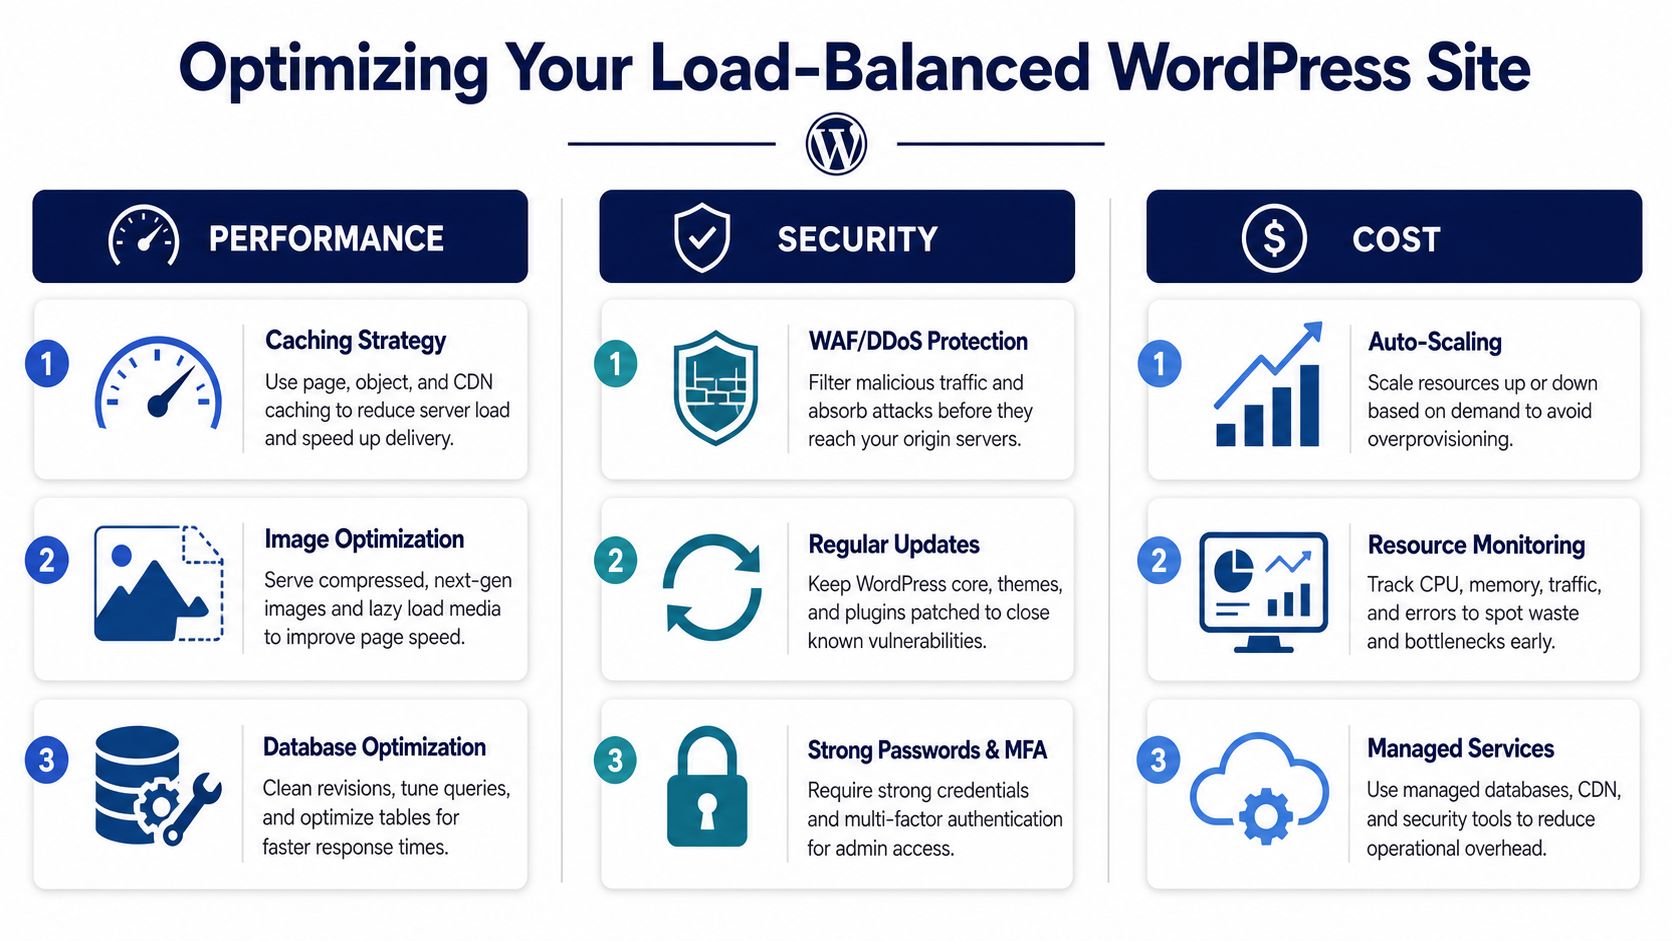
Load Balancing macht einen WordPress-Stack nicht automatisch effizient. Bei kleineren oder schlecht abgestimmten Websites kann es Netzwerk-Hops, Cache-Komplexität und Betriebskosten hinzufügen, bevor es den eigentlichen Engpass behebt.
Performance-Disziplin
Sobald ein Cluster live ist, hängt die Performance meist weniger vom Load Balancer selbst ab als vom Cache-Verhalten, von den Reserven bei den PHP-Workern und von den Datenbank-Abfragemustern. Deshalb definieren reife Teams Cache-Regeln explizit, statt Caching als Plugin-Einstellung zu behandeln.
Eine sinnvolle Standardeinstellung ist einfach. Cachen Sie statische Assets aggressiv. Verwenden Sie kürzere TTLs für Seiten, die sich häufig ändern. Leeren Sie den Cache bei Inhaltsupdates, Produktänderungen und wichtigen redaktionellen Ereignissen. Die genauen Zeiten hängen von der Anwendung ab, aber das Betriebsprinzip bleibt gleich: Stabile Inhalte sollten so lange wie möglich von PHP und MySQL ferngehalten werden.
Monitoring braucht dieselbe Disziplin. Beobachten Sie Antwortzeit, CPU-Sättigung, erschöpfte PHP-Worker, Cache-Trefferquote und Datenbanklatenz gemeinsam. Reine Verfügbarkeit verbirgt viele Probleme. Eine Website kann technisch erreichbar bleiben, während der Checkout langsamer wird, Admin-Aktionen hängen oder angemeldeter Traffic sich hinter ungecachten Anfragen staut.
Legen Sie Alert-Schwellen früh genug fest, damit das Team handeln kann, bevor Nutzer etwas merken. In vielen WordPress-Umgebungen heißt das, bei anhaltendem Ressourcendruck und steigender Anwendungslatenz zu alarmieren, statt auf einen Totalausfall zu warten.
Sicherheitslage
Ein WordPress-Setup mit Load Balancing sollte die Angriffsfläche verkleinern. Der öffentliche Einstiegspunkt sind Load Balancer und Sicherheitsschicht. Applikationsknoten sollten keinen direkten Internet-Traffic annehmen, außer es gibt einen konkreten betrieblichen Grund und kompensierende Kontrollen.
Halten Sie Origin-Instanzen nach Möglichkeit privat. Beschränken Sie den Verwaltungszugriff. Terminieren Sie TLS sauber. Wenn die Website ein relevantes Expositionsprofil hat, setzen Sie eine WAF vor den Load Balancer und stellen Sie sicher, dass die Zugriffsregeln des Origins nur diesem Pfad vertrauen. Das ist bei WooCommerce, Mitgliederplattformen und Redaktionsteams, die von vielen Standorten aus in wp-admin arbeiten, noch wichtiger.
Ein zentraler Eingangspunkt macht auch die Reaktion auf Vorfälle sauberer. Logs, Rate Limits, IP-Kontrollen und Bot-Filterung funktionieren besser, wenn Traffic über einen einzigen kontrollierten Pfad hereinkommt.
Kostenkontrolle
Teams bauen oft zu groß. Ein Cluster aus drei Knoten mit verwalteter Datenbank, Redis, Object Storage, CDN, WAF und Auto-Scaling kann für eine geschäftskritische Plattform die richtige Antwort sein. Er ist aber auch eine teure Antwort auf ein Problem, das sich vielleicht mit Full-Page-Caching, besserem Abfrage-Tuning oder mehr Kapazität auf einem einzelnen Knoten hätte lösen lassen.
Kostenkontrolle beginnt damit, die Architektur an die Last anzupassen. Wenn der Traffic Spitzen hat, aber überwiegend anonym ist, investieren Sie zuerst in Caching und CDN-Offload. Wenn der Traffic dauerhaft hoch ist und von angemeldeten Nutzern stammt, widmen Sie PHP-Parallelität, Effizienz des Object Cache und Datenbankkapazität mehr Aufmerksamkeit. Wenn die Plattform strenge Verfügbarkeitsanforderungen hat, kann Redundanz höhere Ausgaben rechtfertigen, noch bevor die durchschnittliche Auslastung hoch wirkt.
Eine praktische Betriebs-Checkliste sieht so aus:
- Messen Sie Sättigung, nicht nur Verfügbarkeit: Steigende Latenz, volle PHP-Worker-Pools und niedrige Cache-Trefferquoten zeigen sich meist vor einem Ausfall.
- Nutzen Sie verwaltete Dienste dort, wo sie echte Routinearbeit abnehmen: Verwaltete Datenbank- und Cache-Schichten sind den Aufpreis oft wert, wenn das Team Backups, Failover, Patching und Wiederherstellung nicht selbst verantworten will.
- Bleiben Sie bei der Architektur ehrlich: Wenn gemeinsamer Storage, Kommunikation zwischen Knoten oder Cache-Misses die Latenz treiben, steigen durch zusätzliche Applikationsknoten meist die Kosten schneller als die Performance.
- Prüfen Sie das Auto-Scaling-Verhalten regelmäßig: Schlechte Schwellenwerte können bei Traffic-Spitzen zu spät skalieren oder zu oft, weil die Anwendung ineffizient ist.
Die besten WordPress-Plattformen mit Load Balancing sind nicht die größten. Es sind die, bei denen jede zusätzliche Schicht eine klare Aufgabe, einen messbaren Nutzen und Betriebskosten hat, die das Team versteht.
Ihr Migrationspfad zu einer skalierbaren Architektur
Behandeln Sie die Migration als stufenweises Engineering-Projekt, nicht als Hosting-Wechsel.
Beginnen Sie mit einem Benchmark der aktuellen Plattform, damit Sie wissen, ob das eigentliche Problem CPU, PHP-Worker, Datenbankkonkurrenz, Cache-Misses oder Datei-I/O ist. Bauen Sie dann die Zielumgebung im Staging auf und validieren Sie zuerst die schwierigen Teile: Login-Verhalten, Medienkonsistenz, Admin-Workflows, geplante Aufgaben und Cache-Invalidierung.
Führen Sie danach kontrollierte Tests gegen den neuen Stack durch und proben Sie den Ausfall. Nehmen Sie einen Knoten aus der Rotation. Bestätigen Sie, dass die Website stabil bleibt. Testen Sie die Veröffentlichung von Inhalten sowie alle Checkout- oder Mitgliederprozesse unter realistischen Bedingungen. Erst dann sollten Sie eine Umstellung planen.
Die saubersten Migrationen nutzen einen stufenweisen Launch mit engem Monitoring direkt nach der Traffic-Umstellung. So hat das Team Zeit, Probleme mit Zustand, Cache oder Routing zu erkennen, bevor sie zu geschäftlichen Vorfällen werden.
WordPress Load Balancing lohnt sich, wenn die Plattform einem einzelnen Knoten entwachsen ist. Es ist ein Fehler, wenn es als Ersatz für grundlegendes Performance-Engineering dient. Den Unterschied macht architektonische Disziplin.
Wenn Ihr Team einen Umstieg auf geclustertes WordPress, WooCommerce mit hohem Traffic oder einen resilienteren Enterprise-Stack plant, kann IMADO Sie dabei unterstützen, die Architektur zu entwerfen, den Migrationspfad zu validieren und eine Plattform zu bauen, die Ihre Redaktion und Ihre Engineers betreiben können.